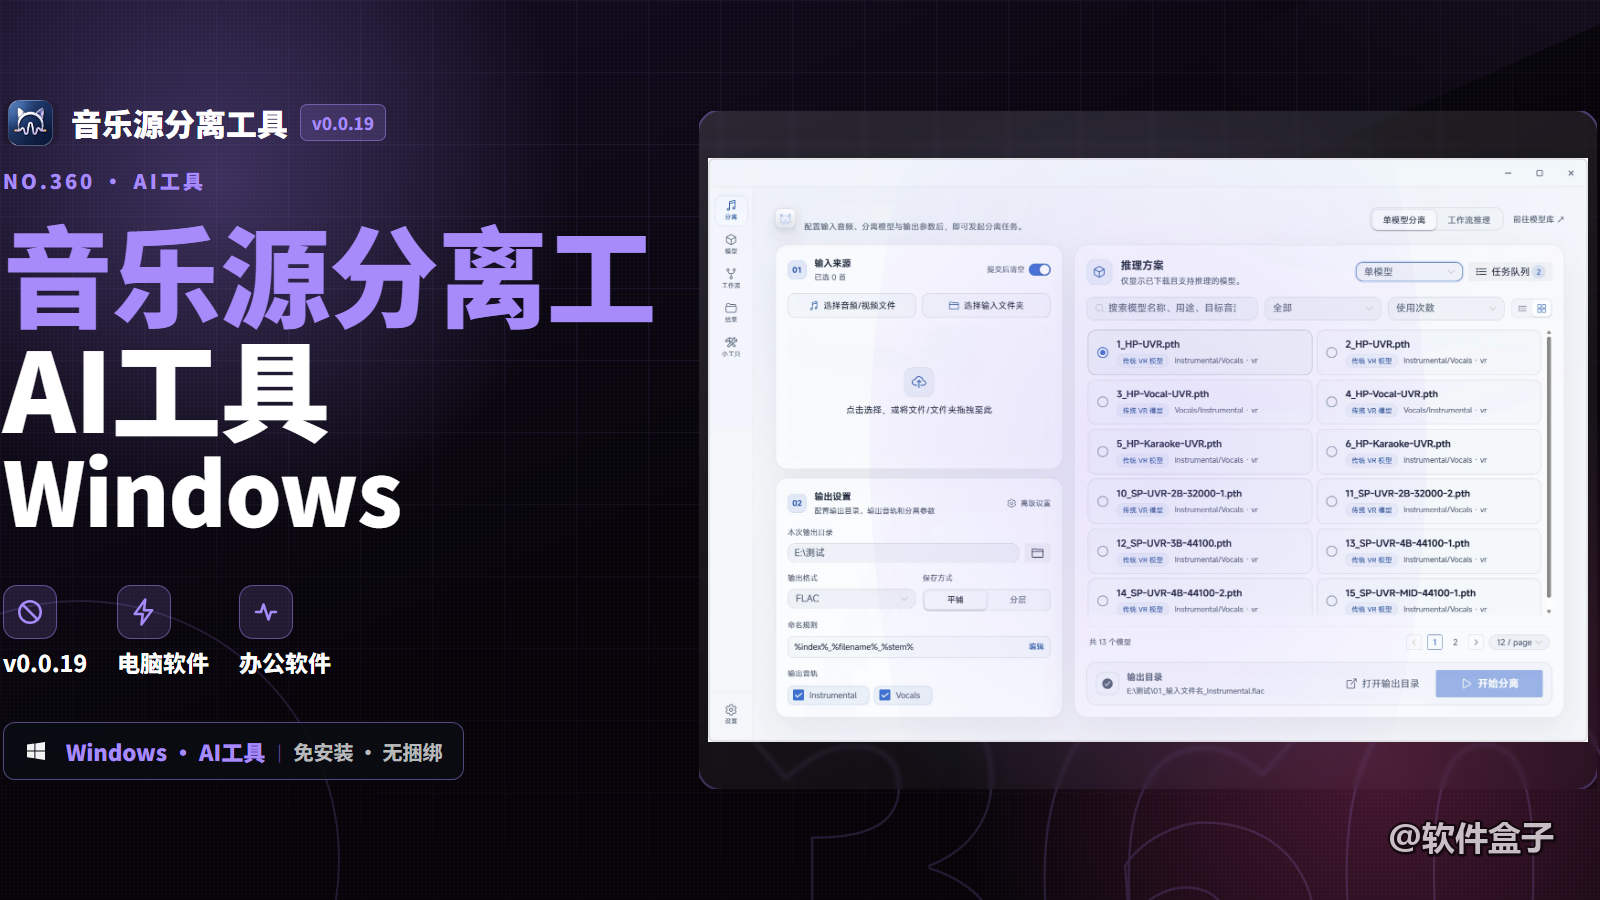
音源分离这事,做剪辑、搞创作的朋友应该都熟。反正我做内容这么多年,后期想扒个BGM、提段伴奏,经常要用到。
日常办公也一样,课程录像、会议记录,事后得把发言人的声音,跟环境音、杂音拆开,原声才留得清楚。
音源分离这事,做剪辑、搞创作的朋友应该都熟。反正我做内容这么多年,后期想扒个BGM、提段伴奏,经常要用到。
日常办公也一样,课程录像、会议记录,事后得把发言人的声音,跟环境音、杂音拆开,原声才留得清楚。
所以人声、伴奏分离这一步,不管做内容,还是职场办公、学习,都少不了。
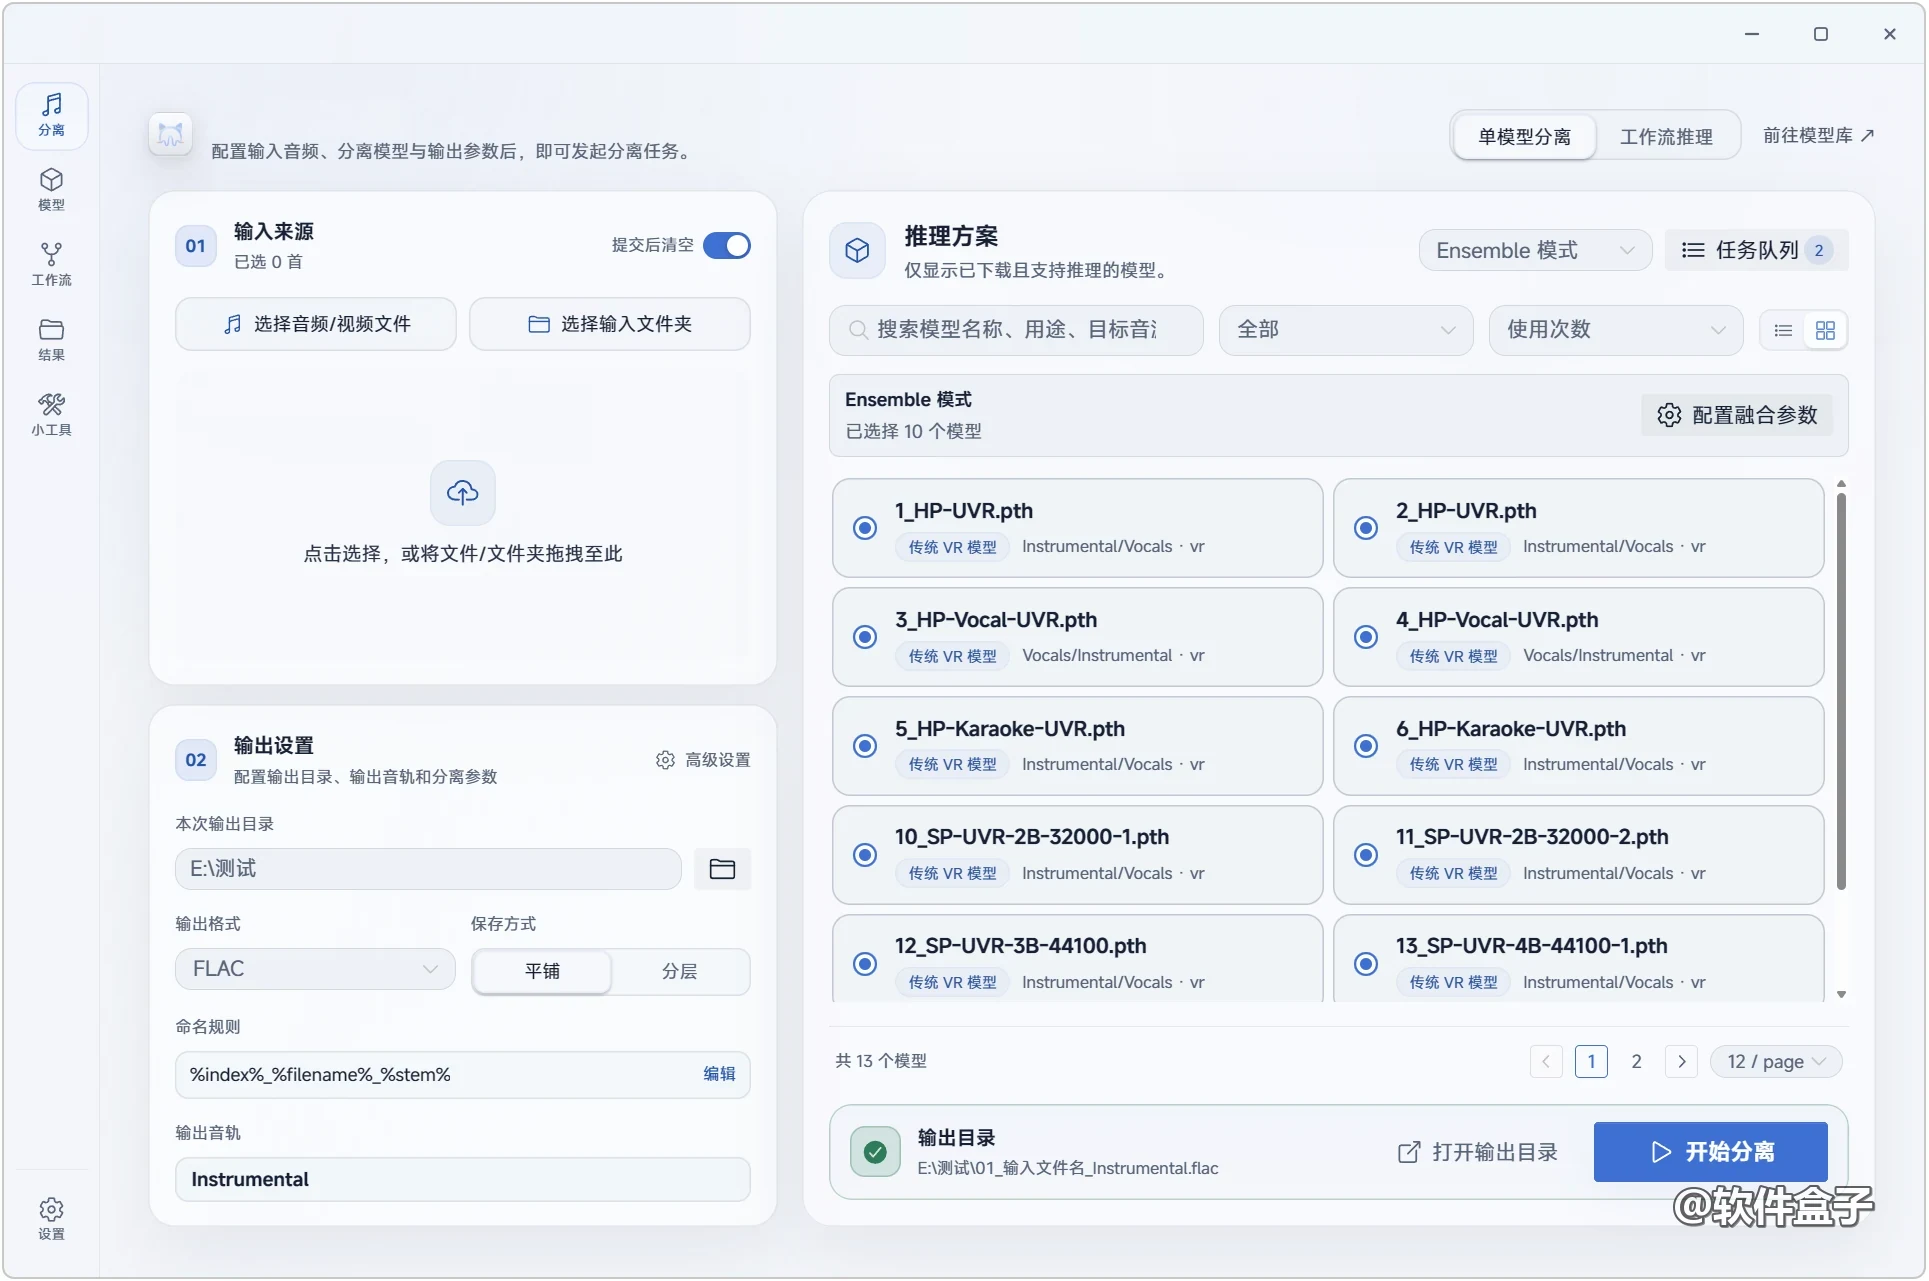
早年基本是单个模型跑到底,现在不一样了,慢慢在往多模型生态走。
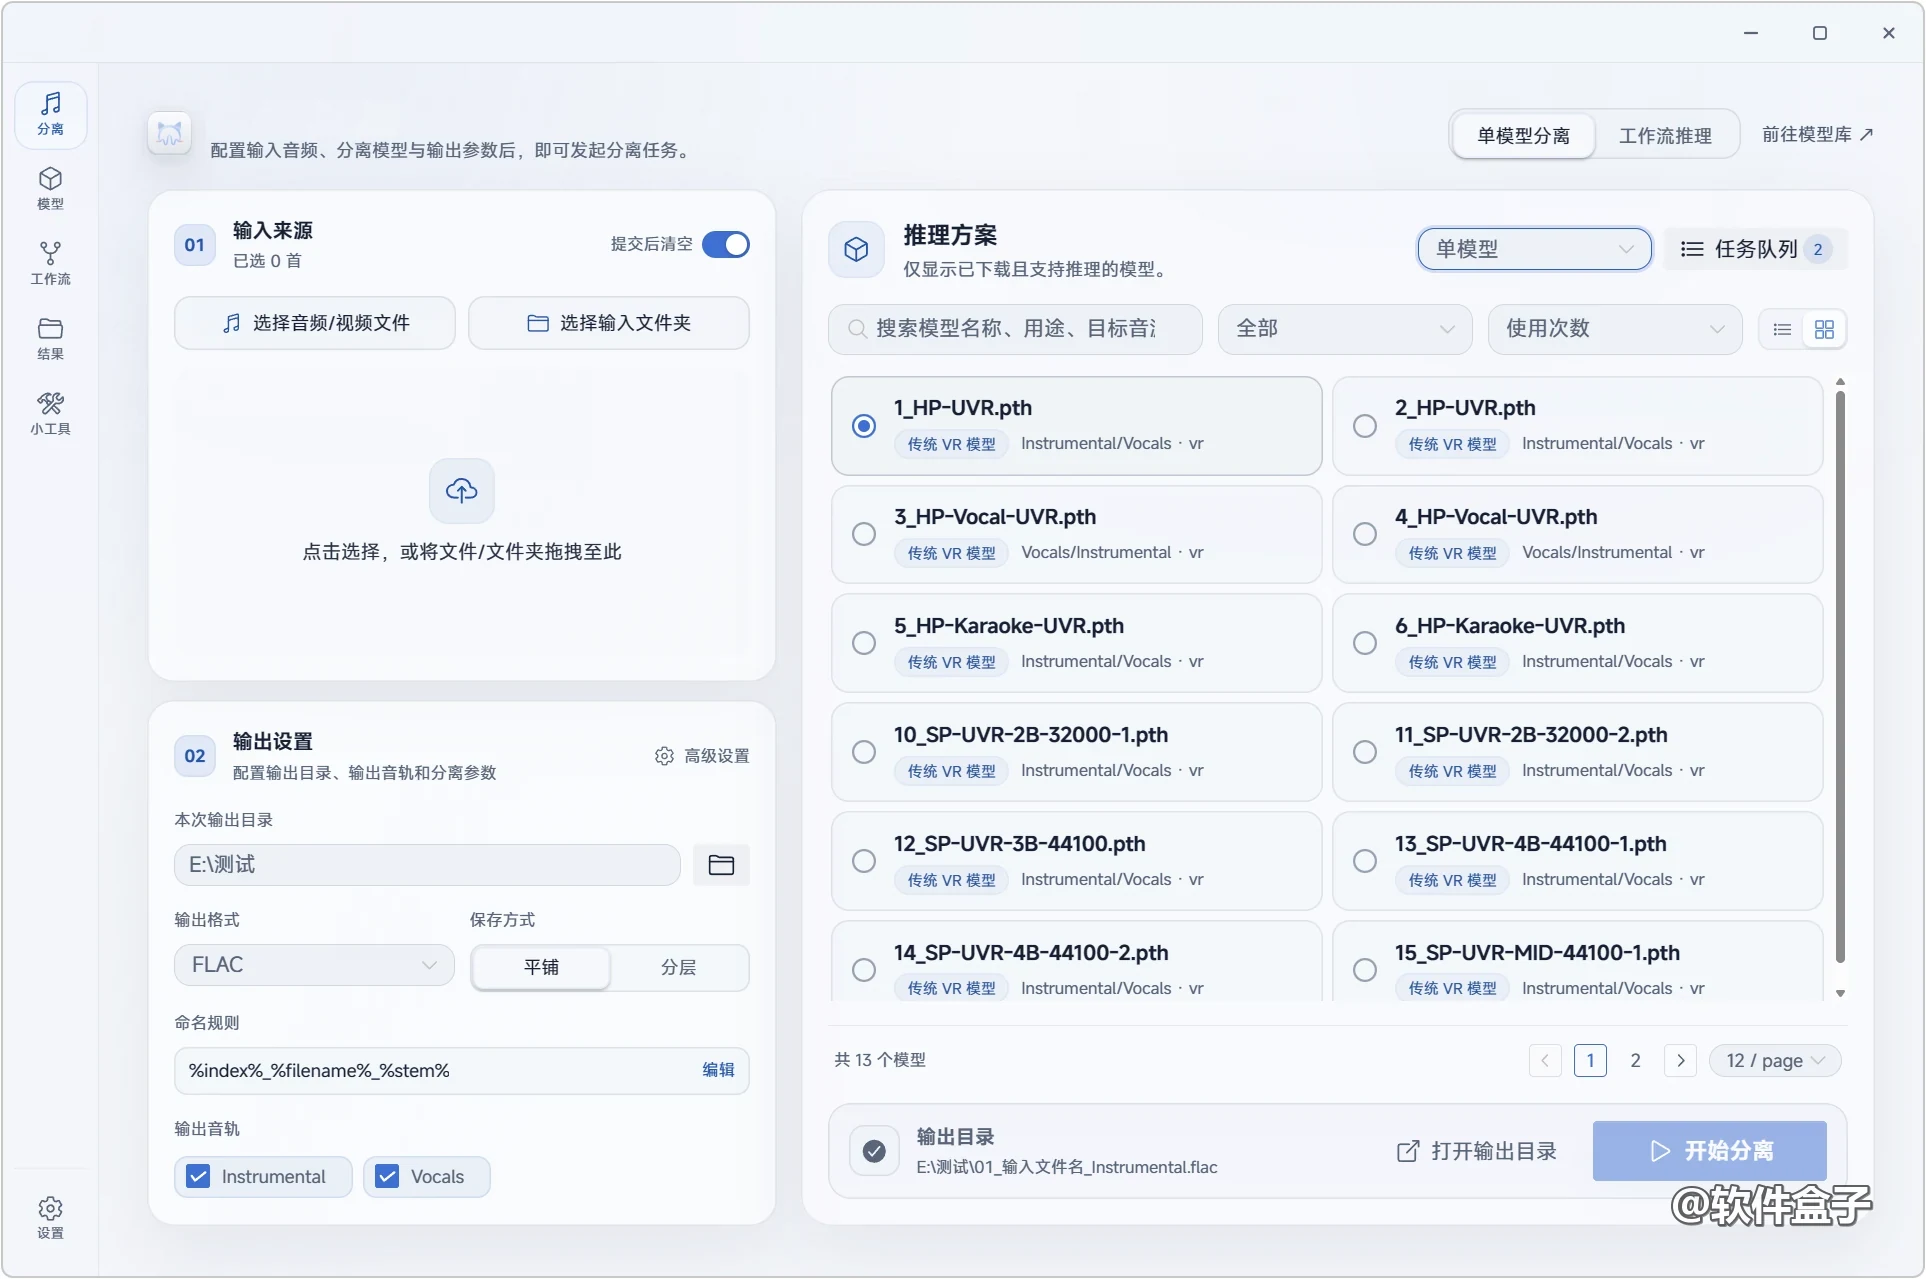
手动加一段音频进去,单模型、混合模型都能选。
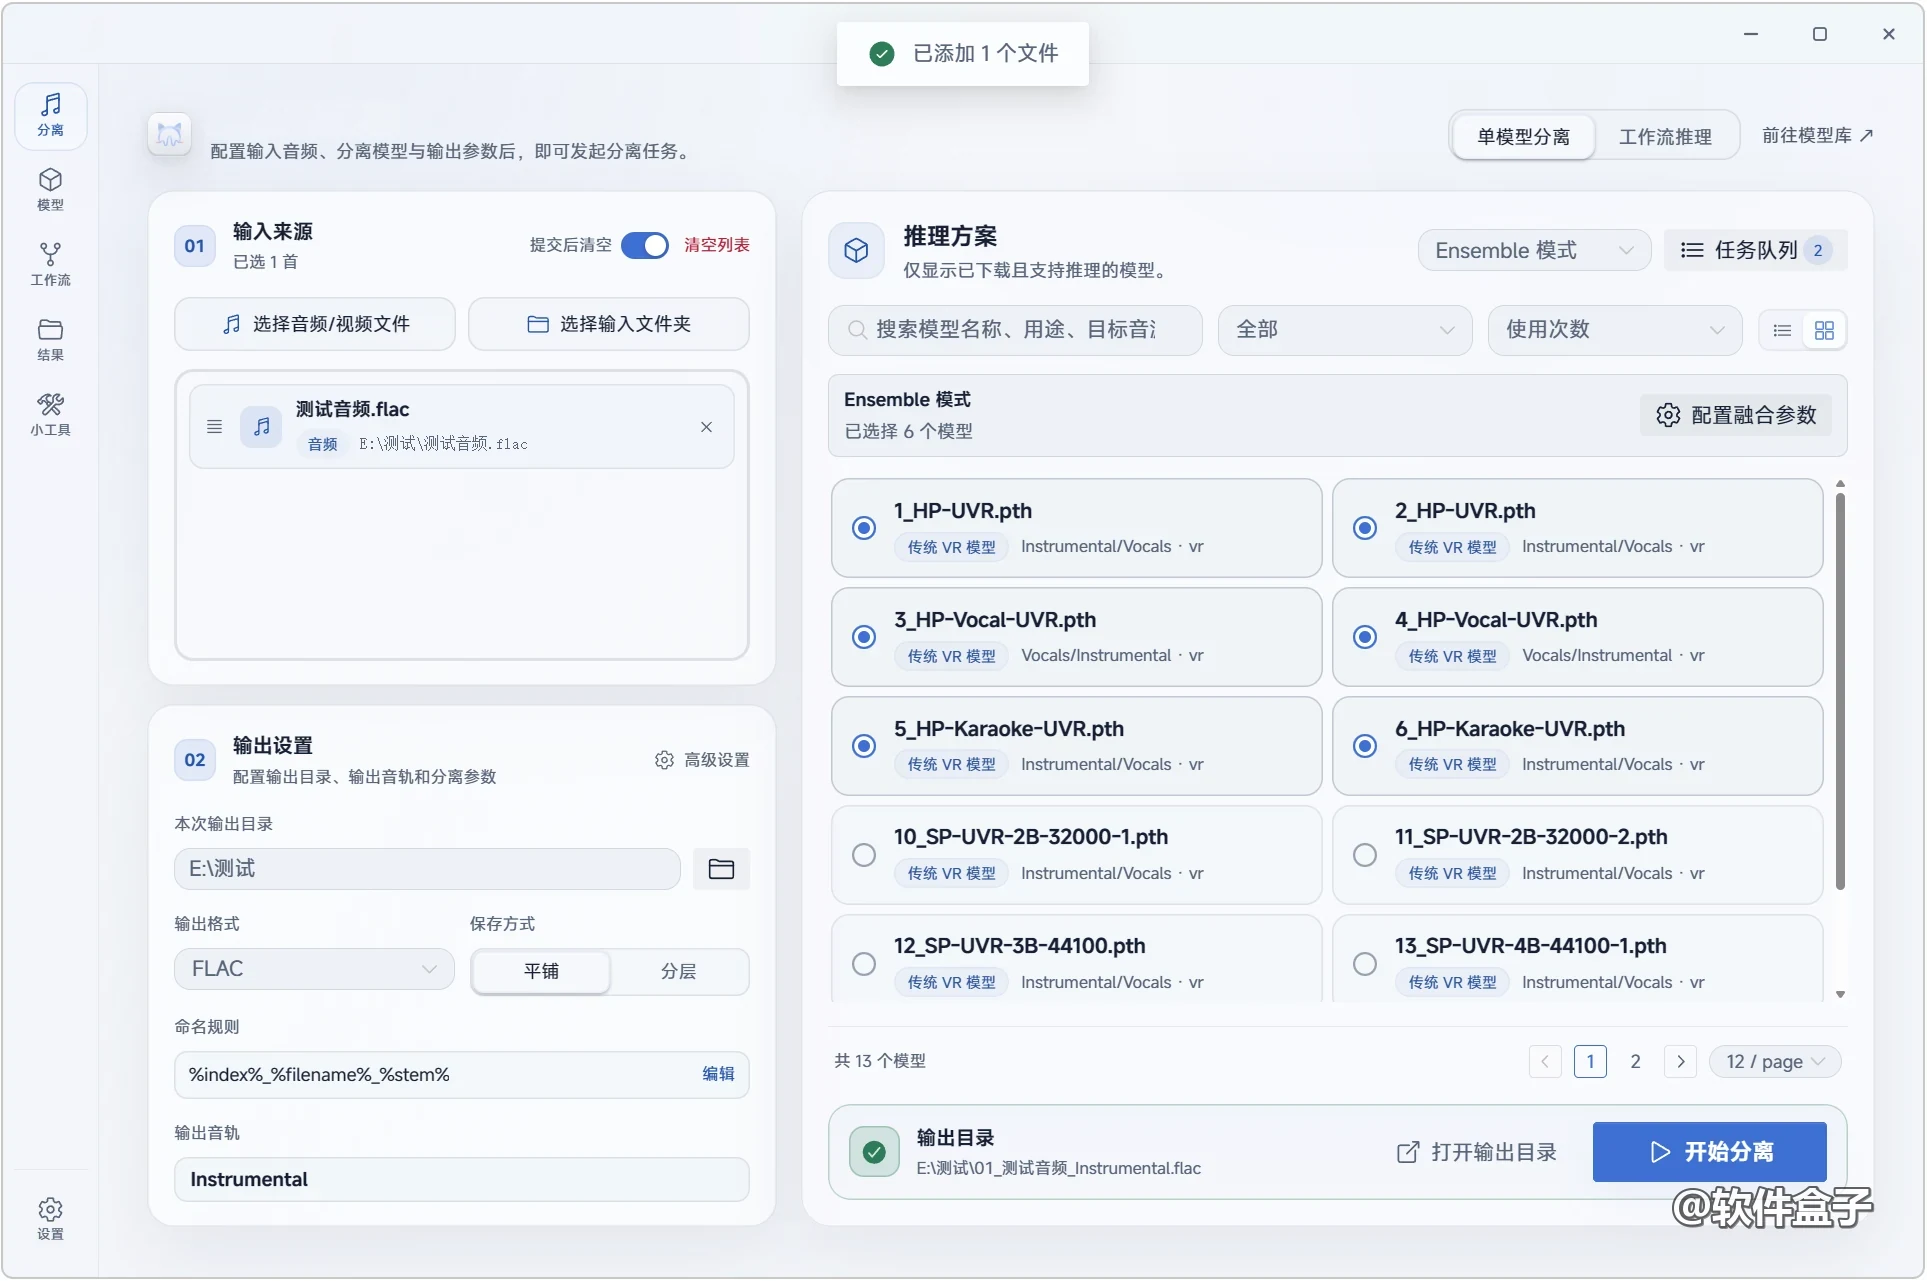
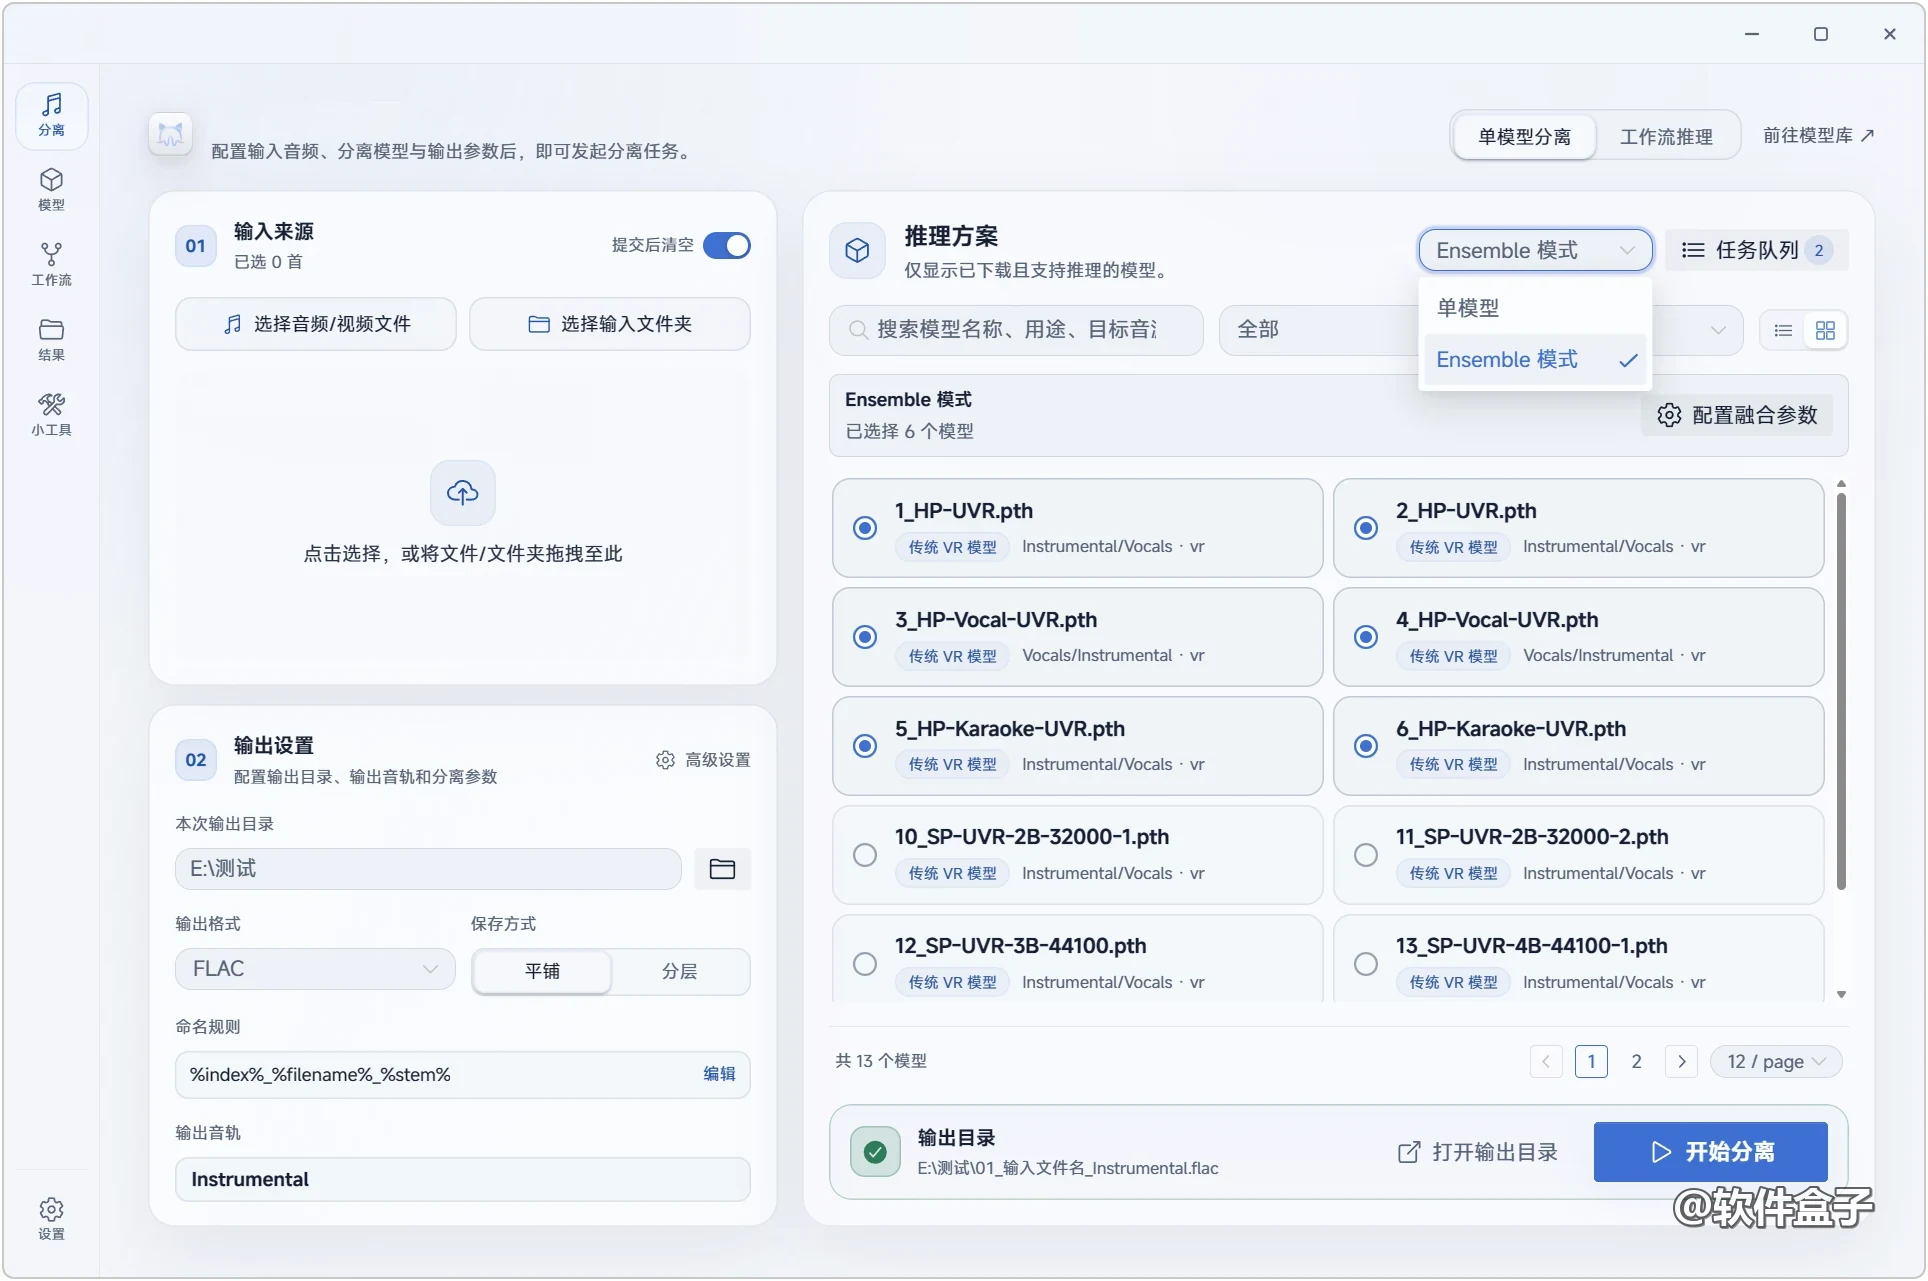
混合模型说白了就是多模型,勾两个以上,再去配融合参数:
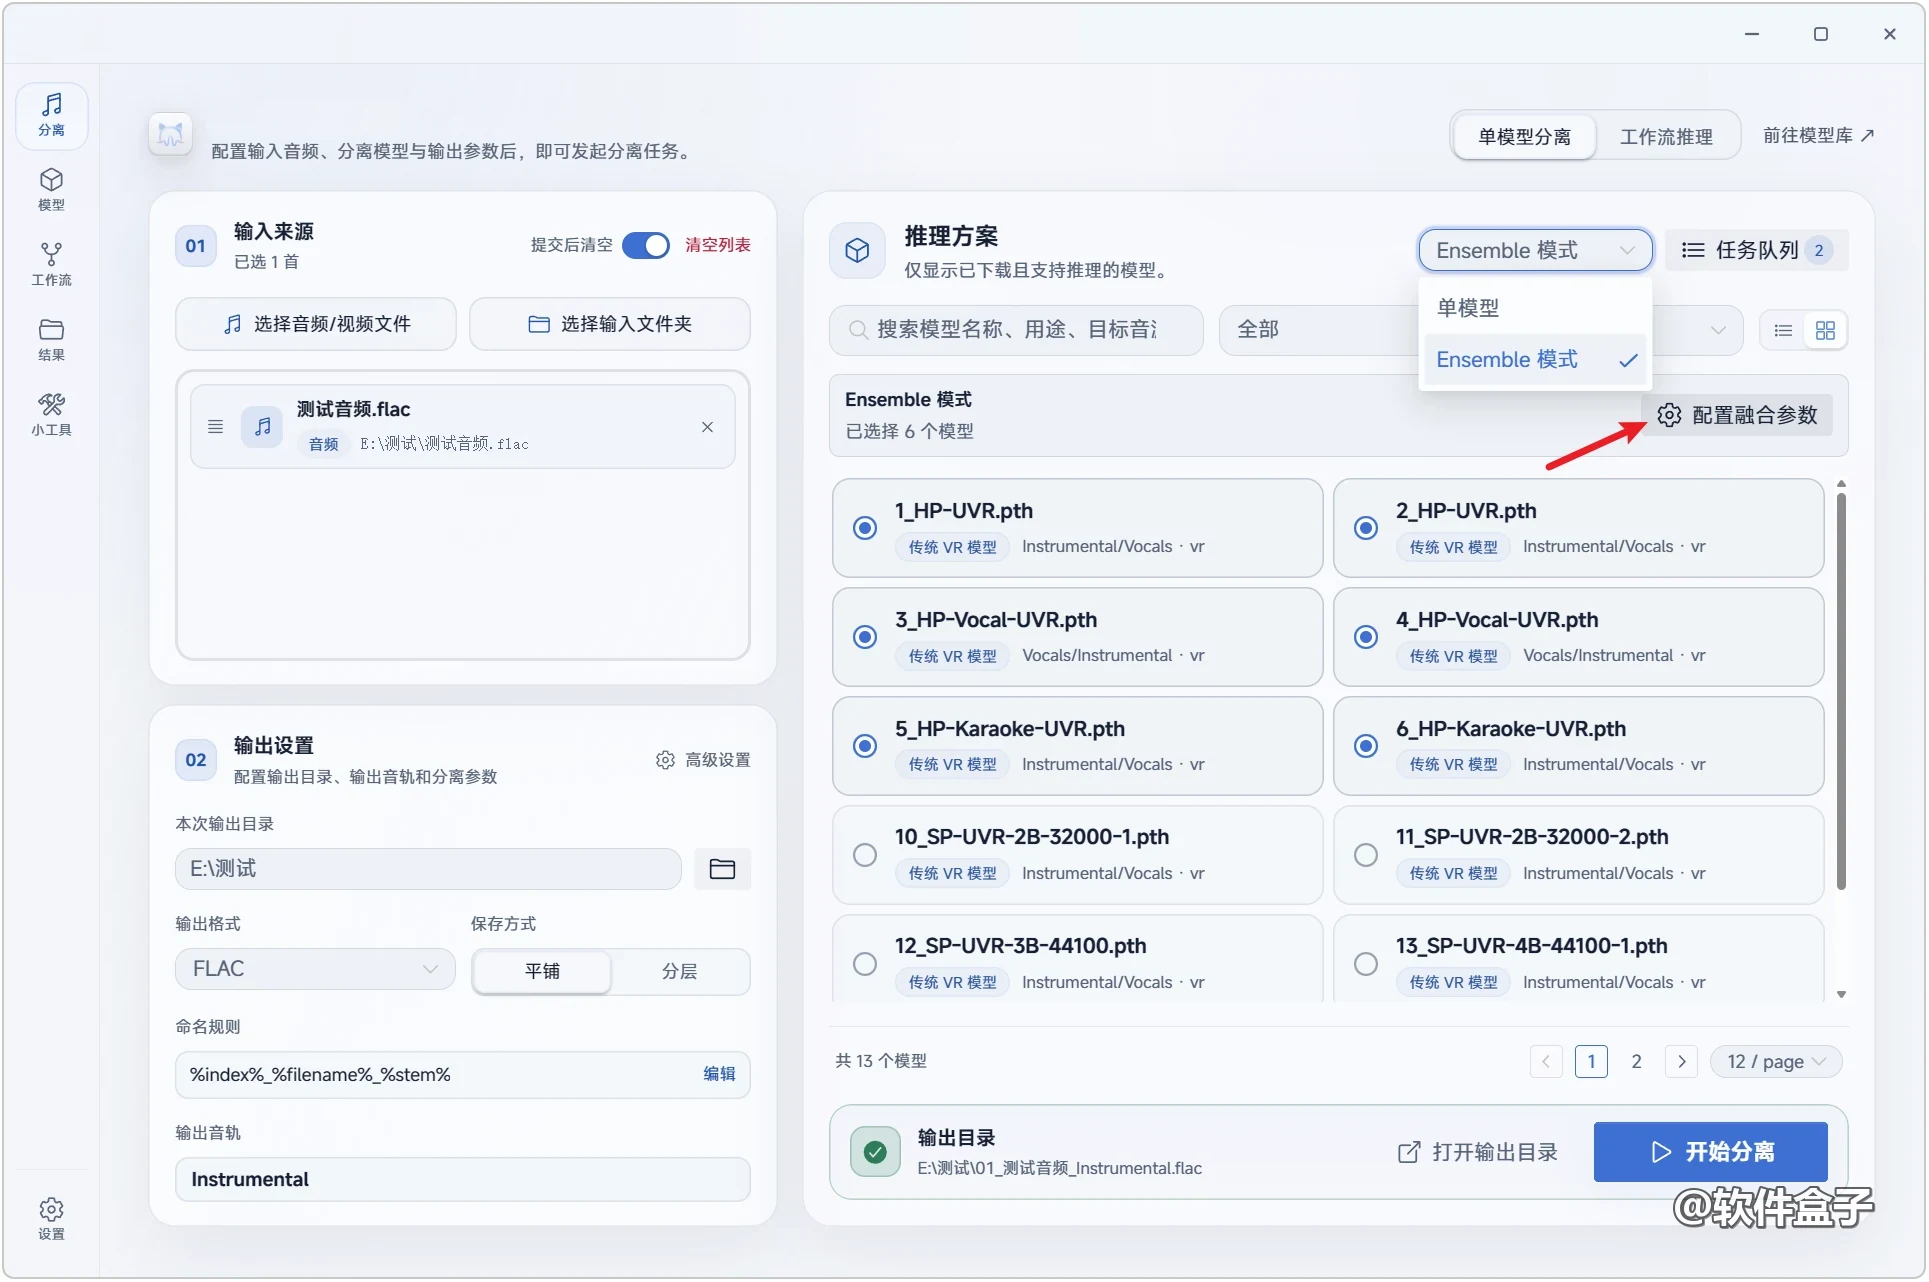
定好哪几个模型管背景音、哪几个管人,然后点开始就行。
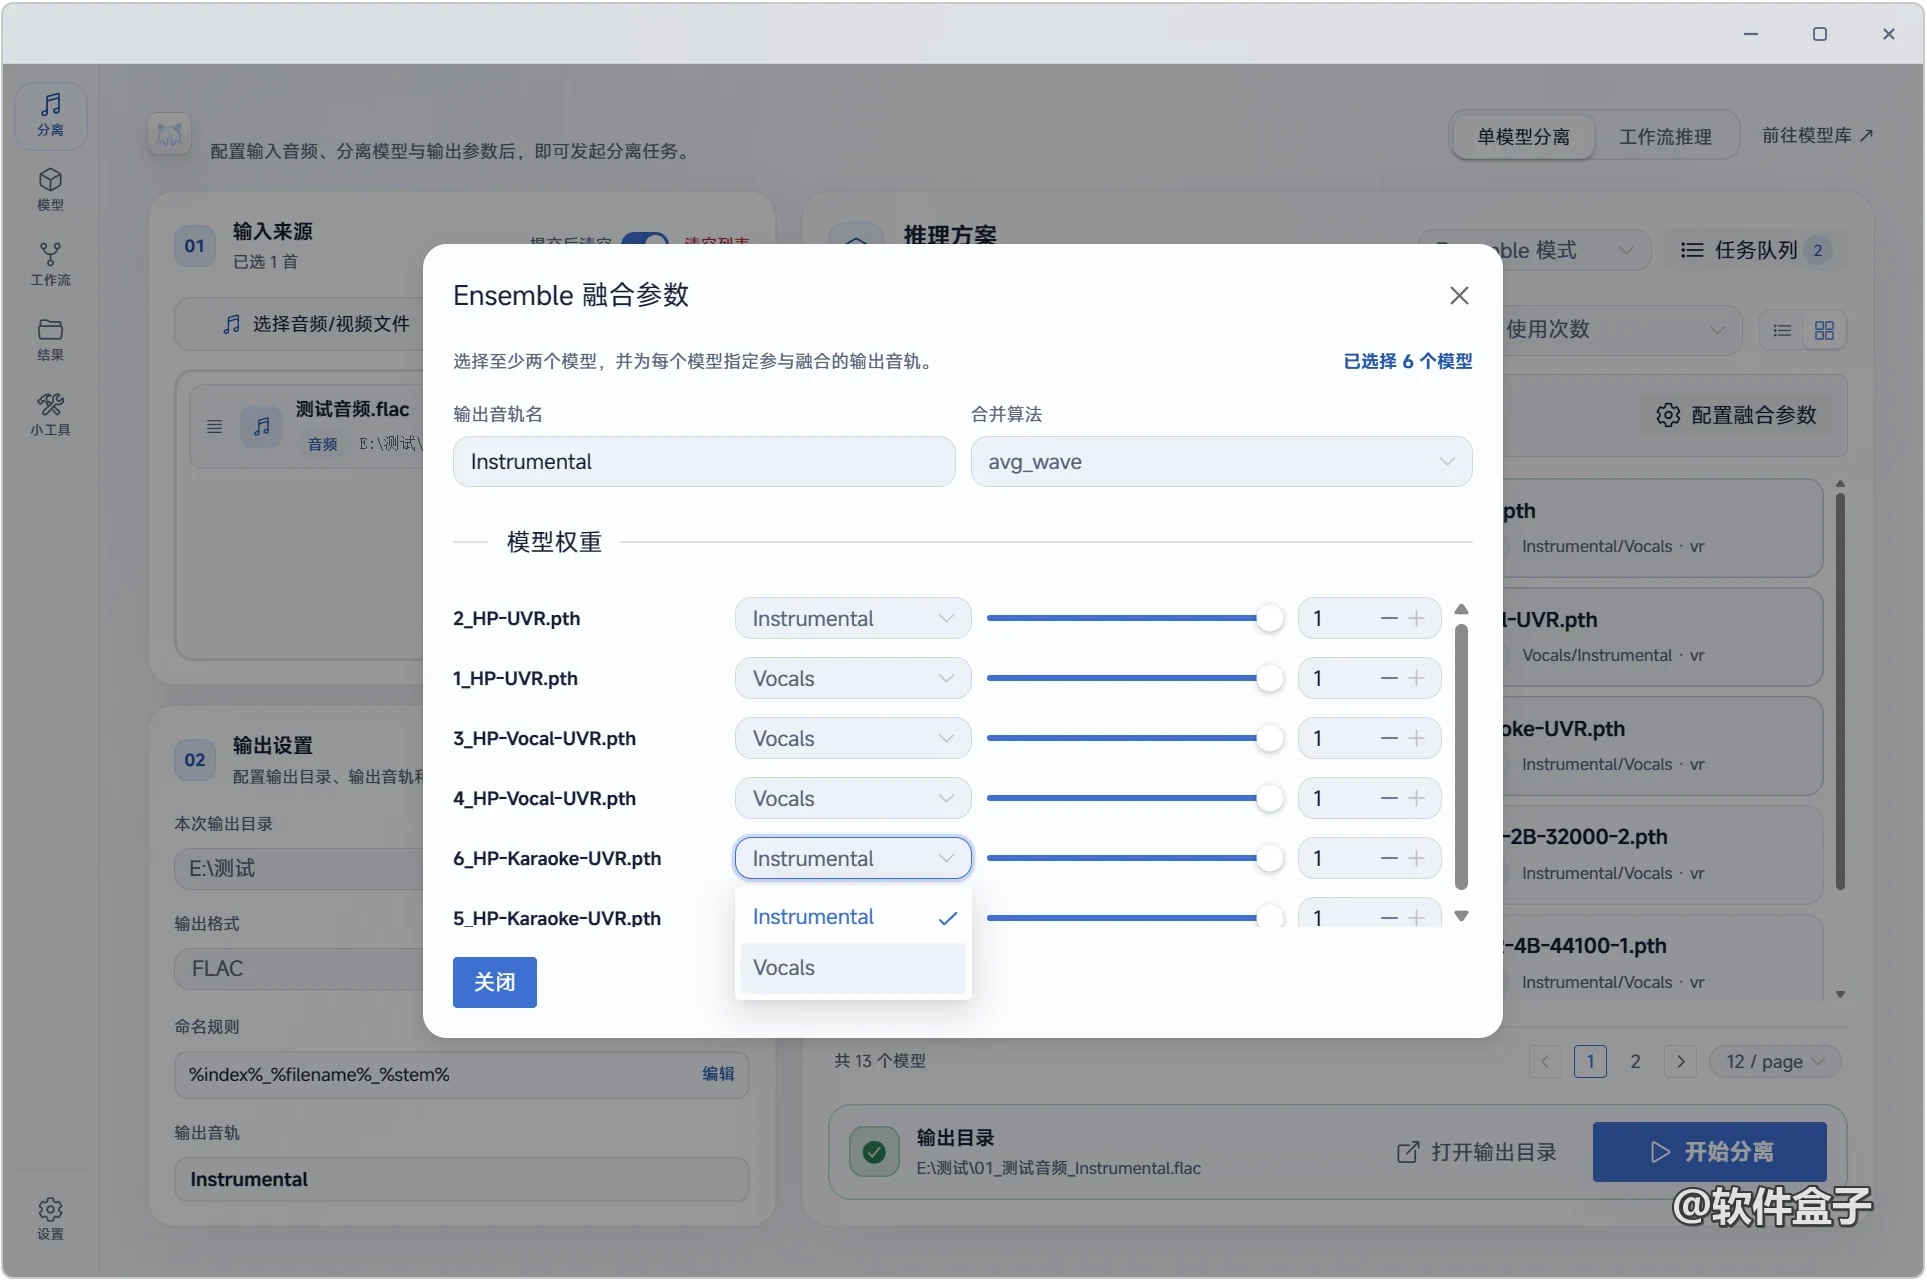
它会自己推理,根据音频的场景、环境,挑合适的处理方式,速度看电脑配置、音频时长和复杂程度,一般1-3分钟。
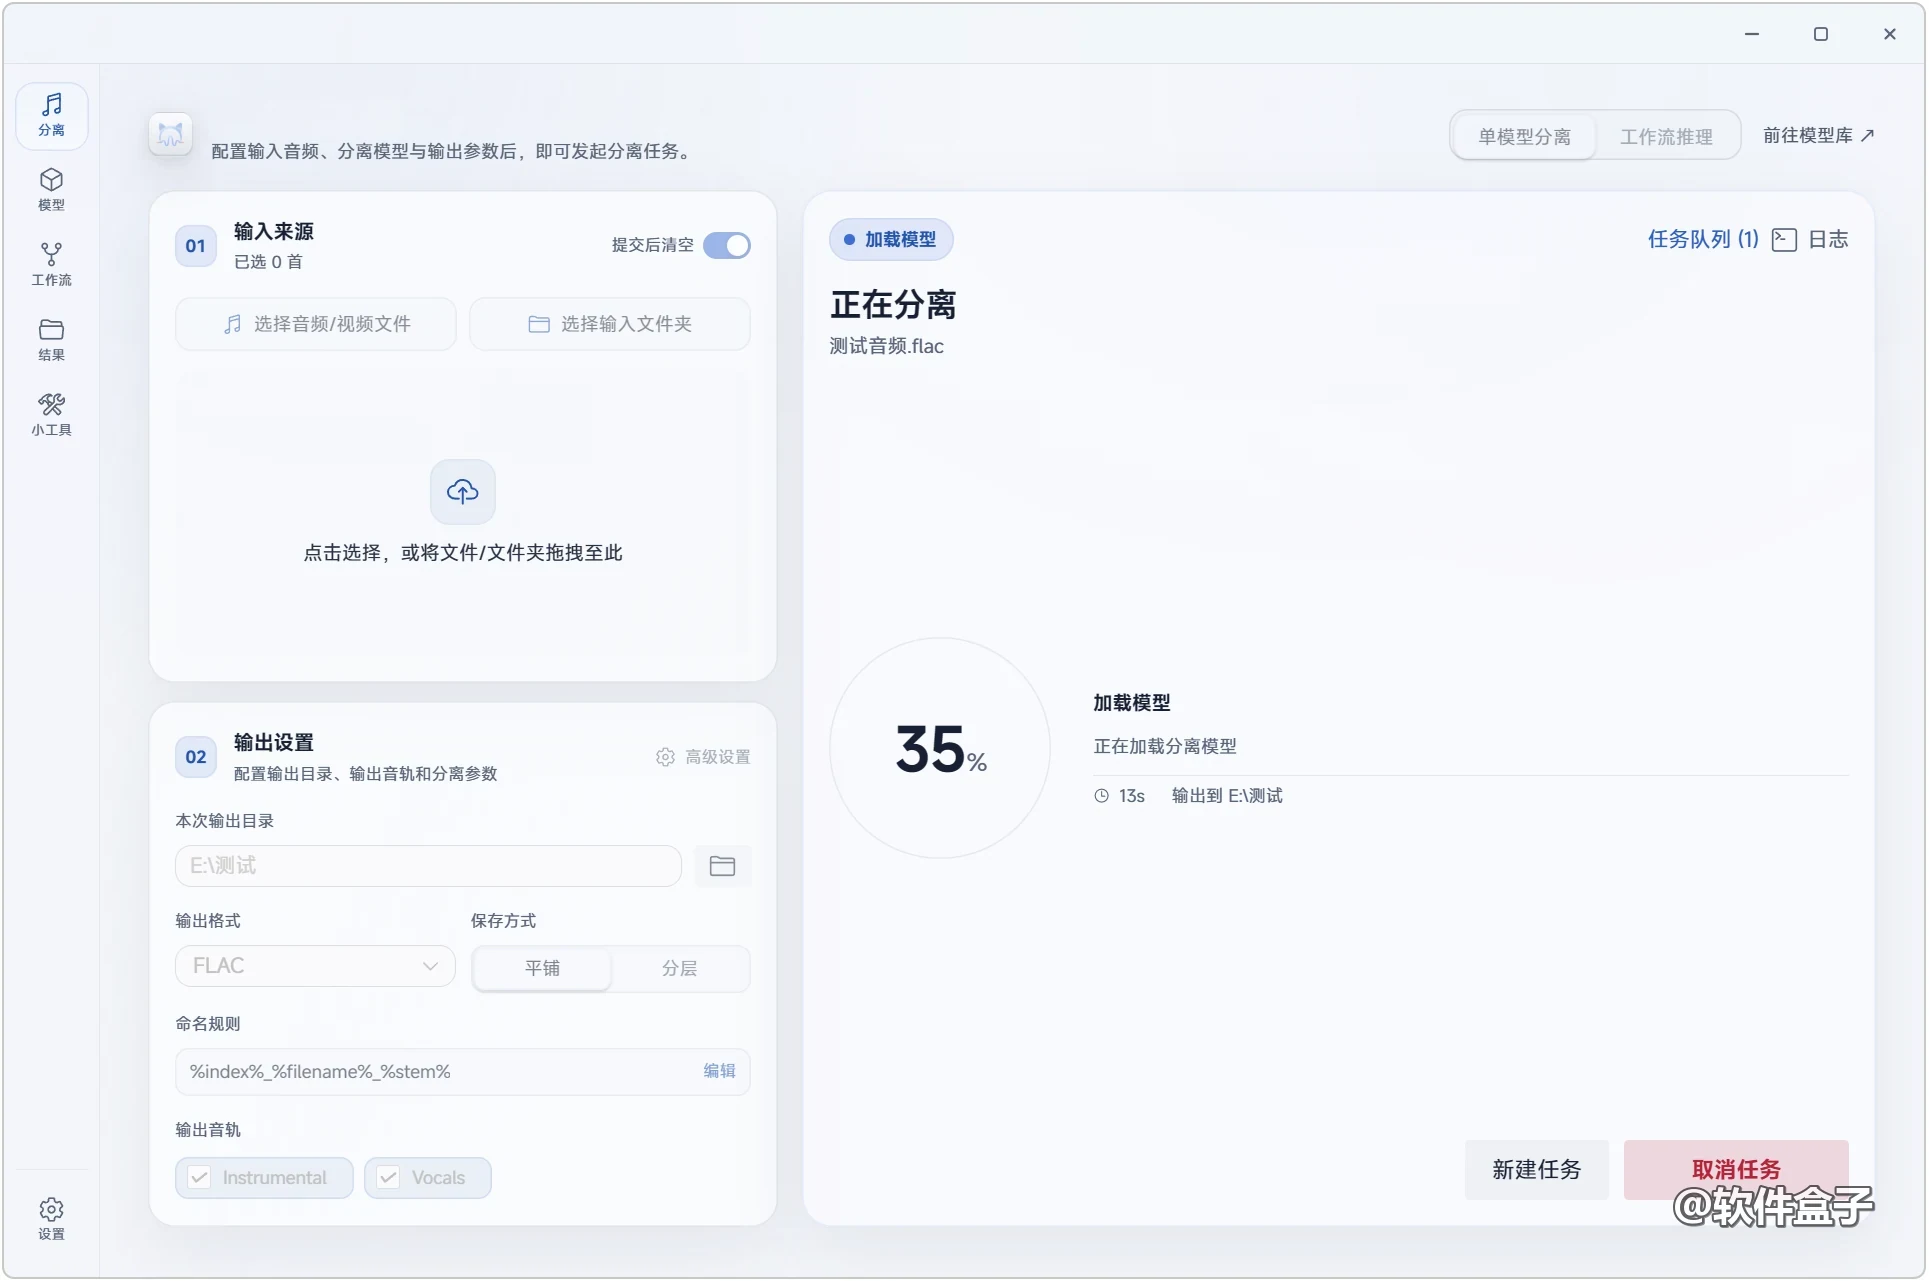
我拿这段4分多钟的试了下,20多秒就跑完了。
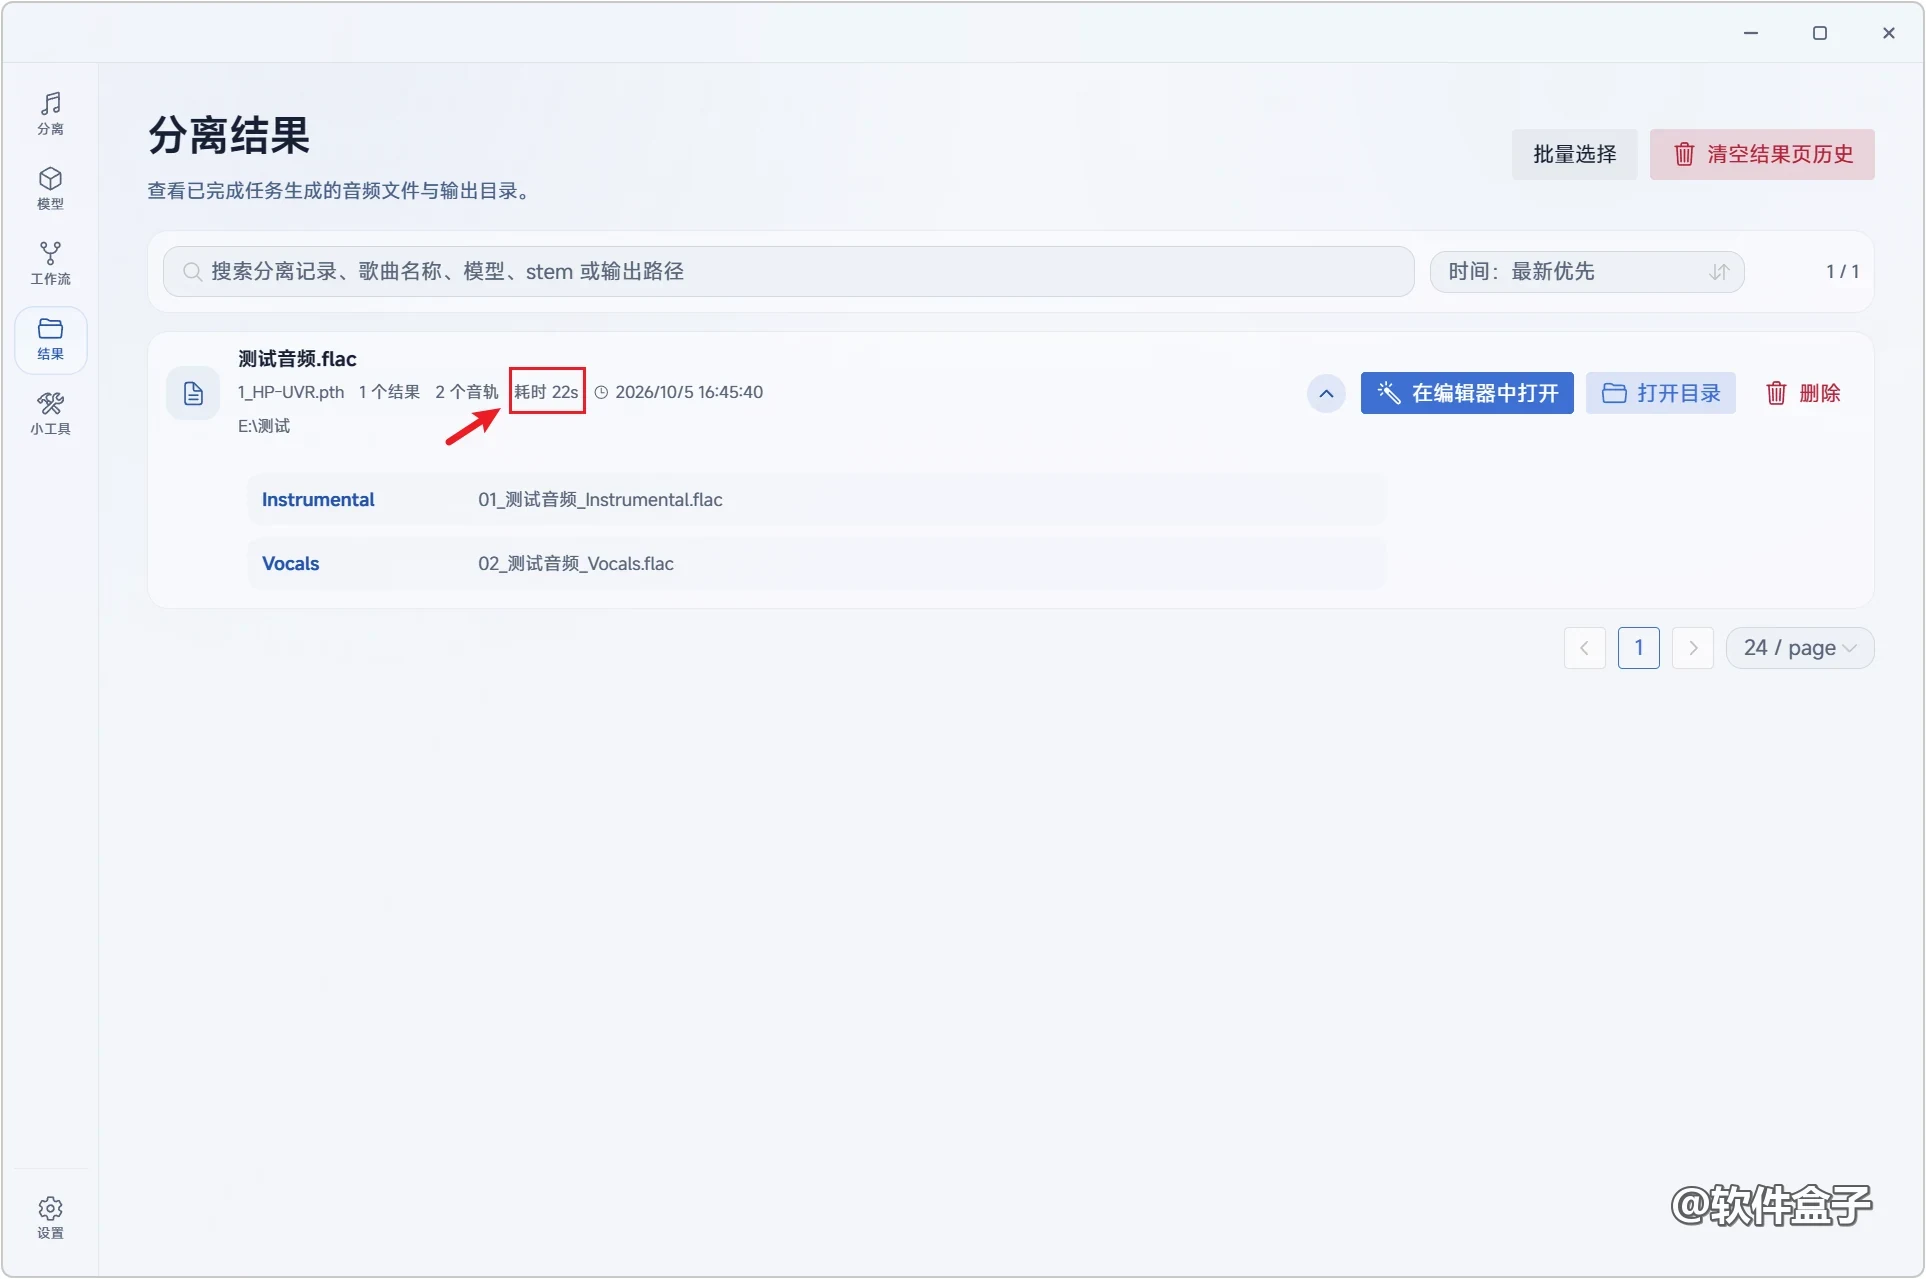
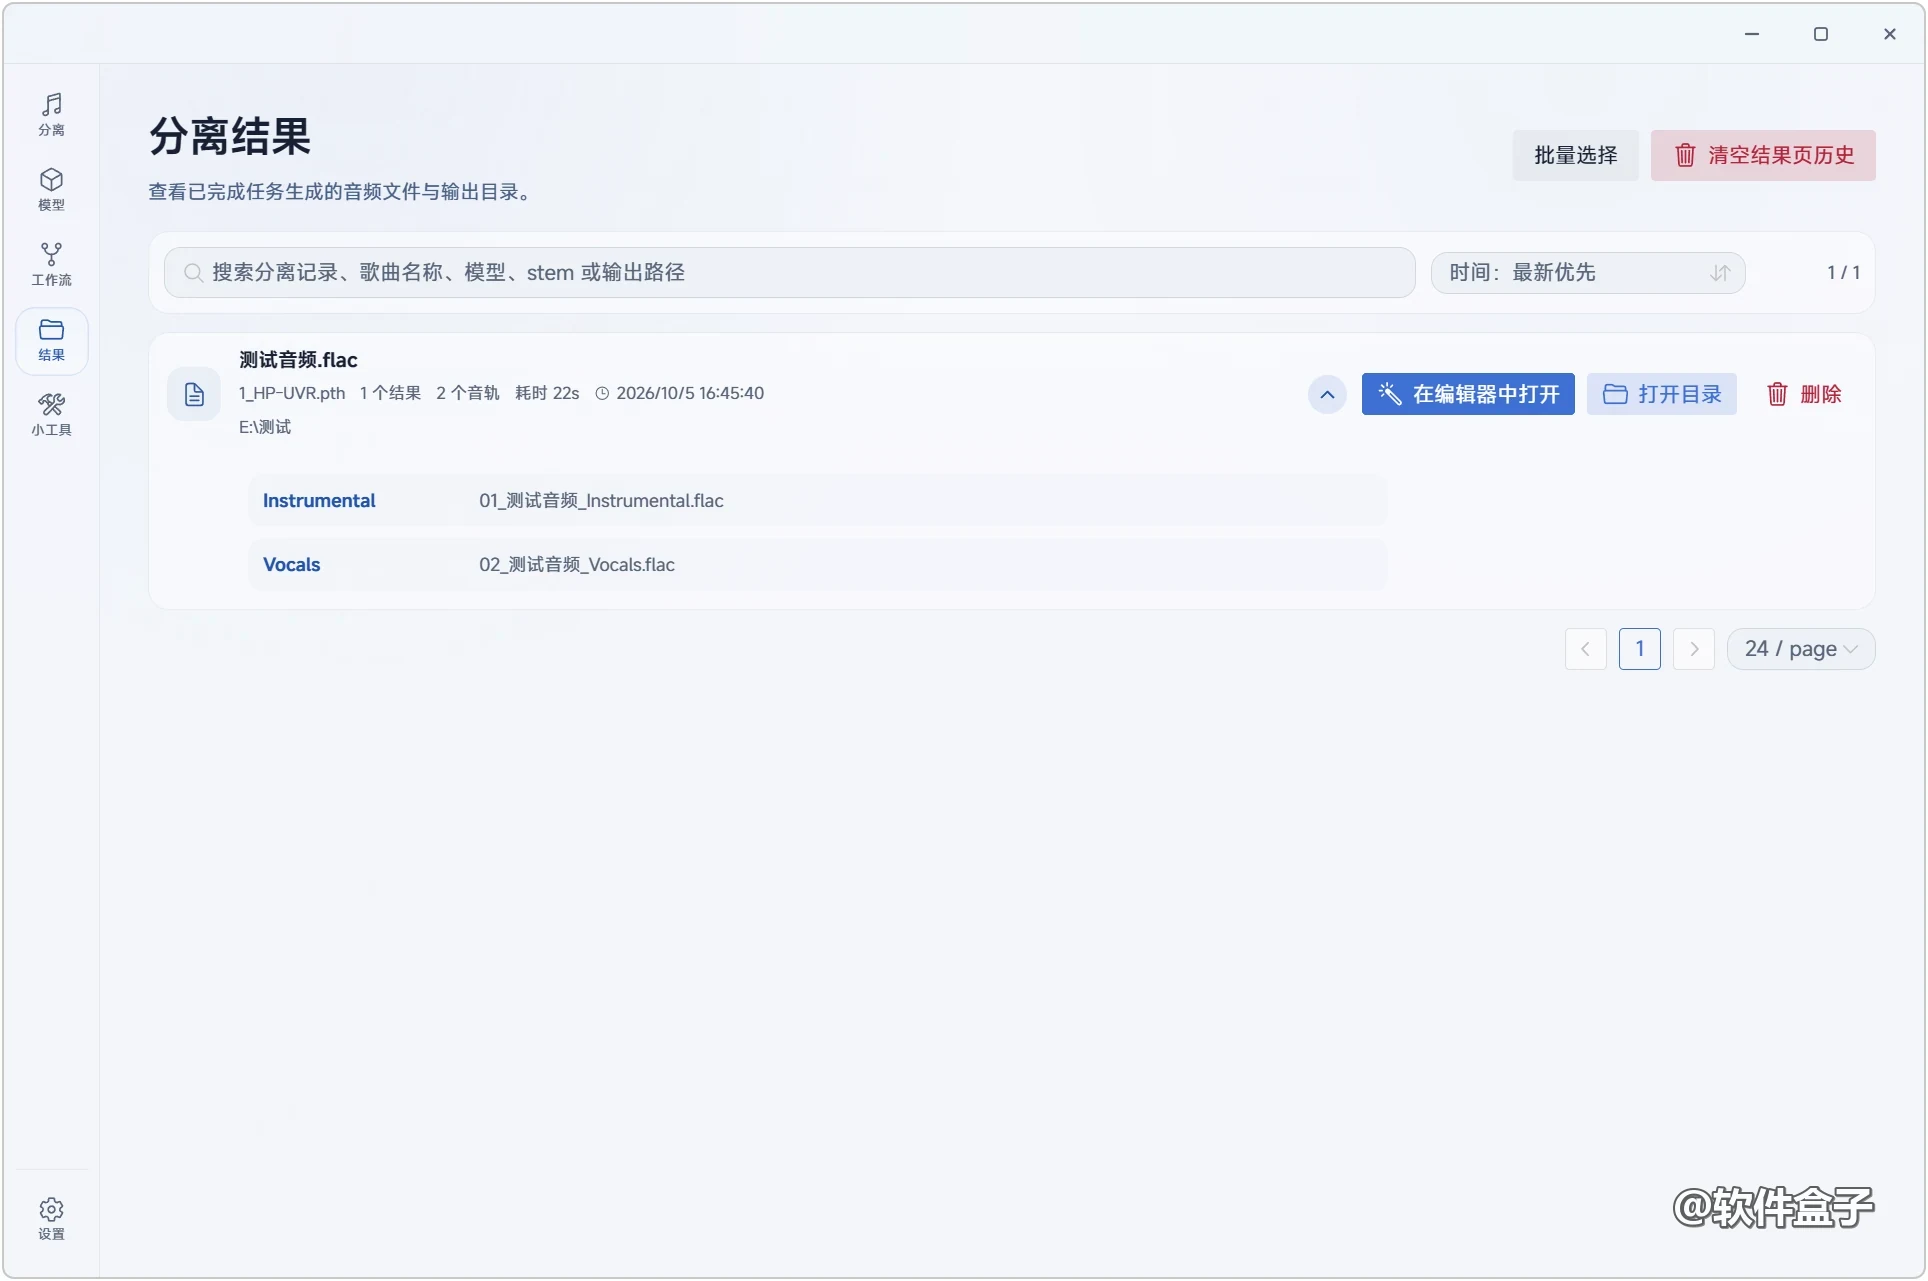
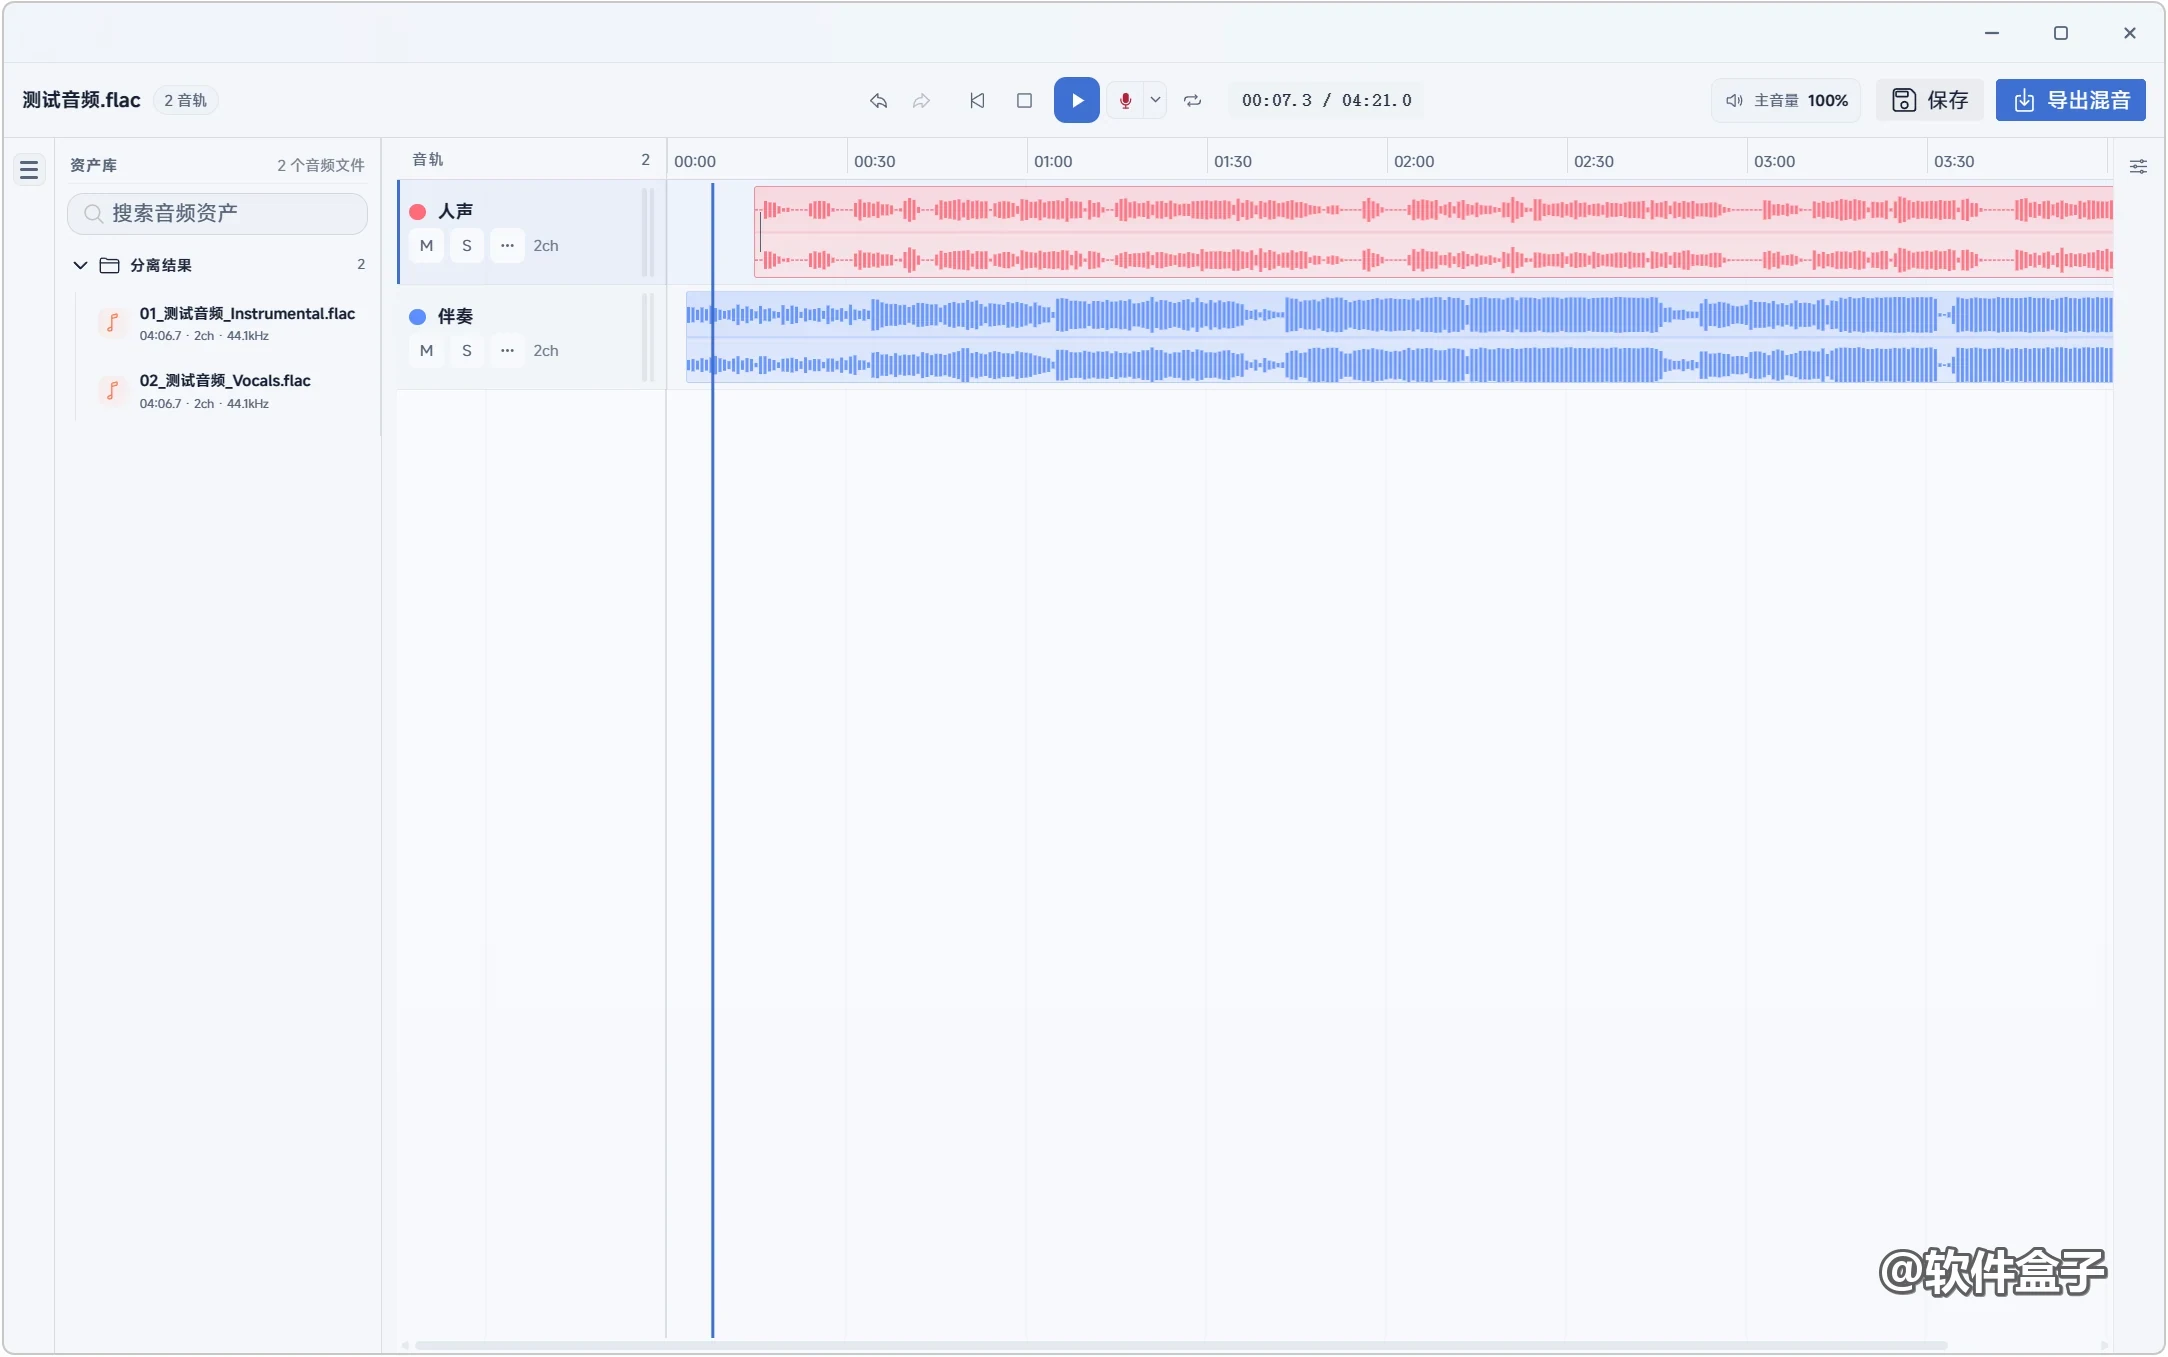
完成后,在结果页直接能听,也能进编辑器打开,接着剪或者导出都行。
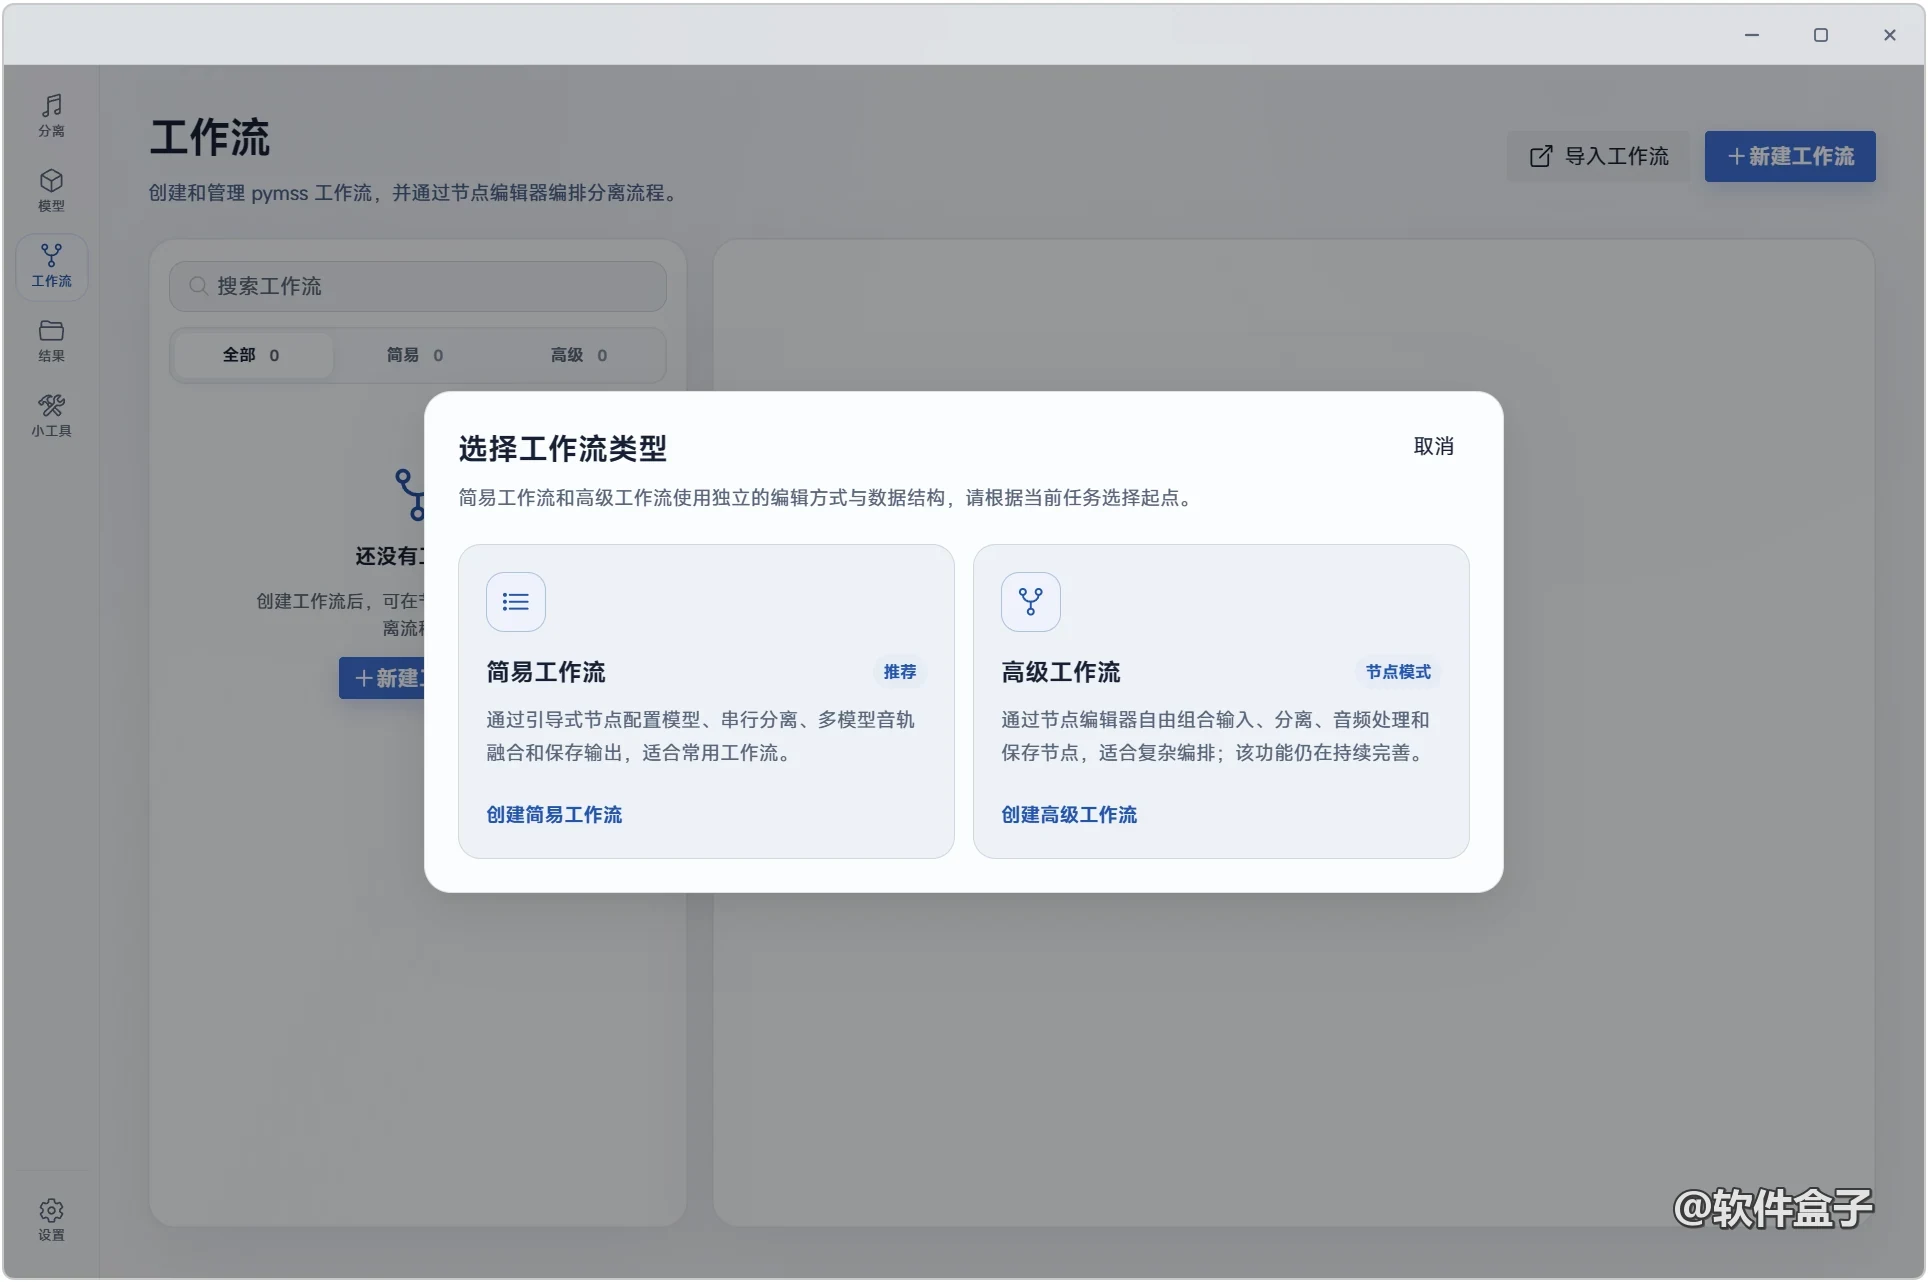
除了手动处理,还支持工作流模式:
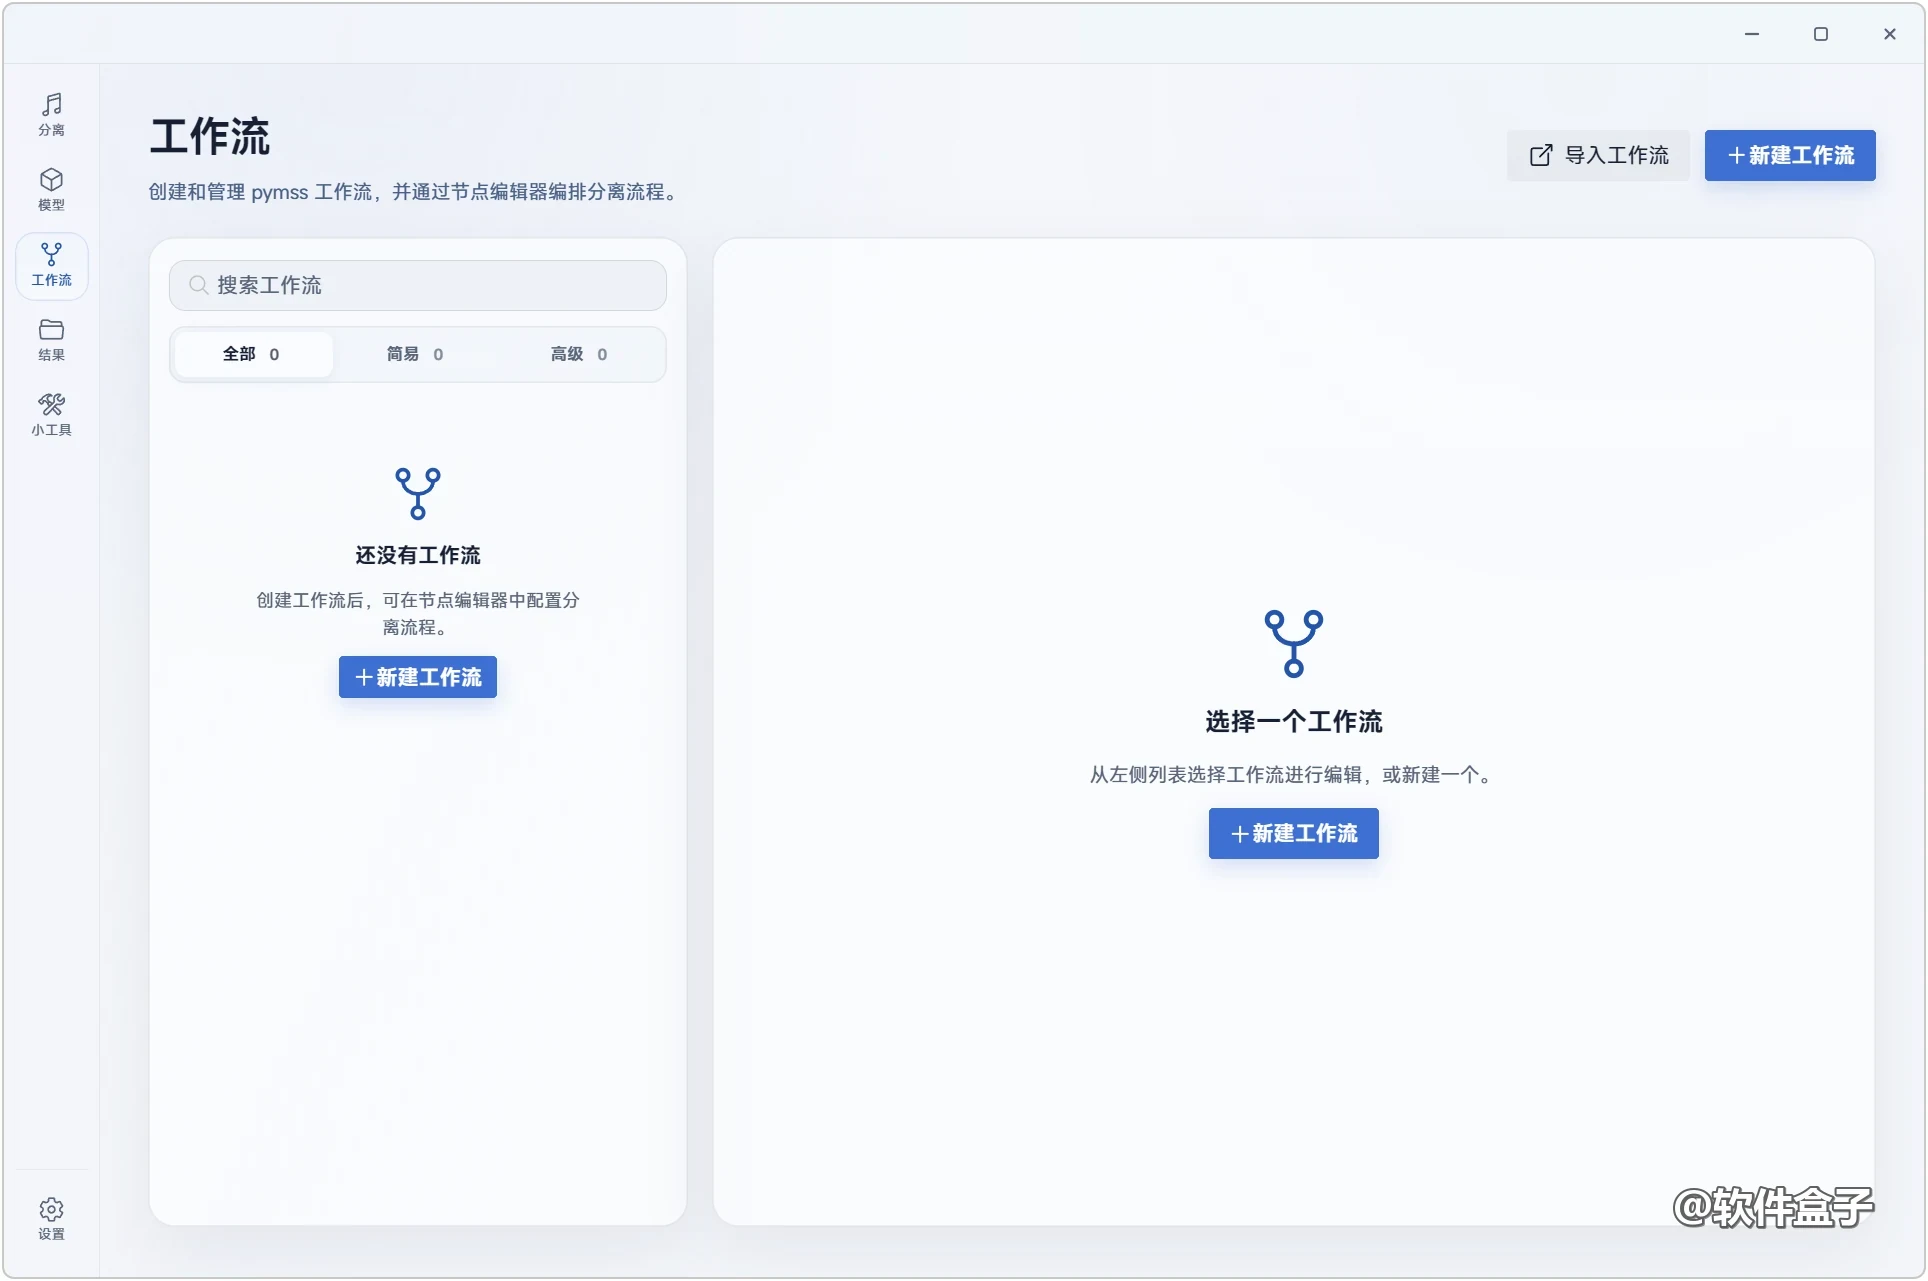
用引导式节点搭成一条自动流程,省得一遍遍重复手工活。
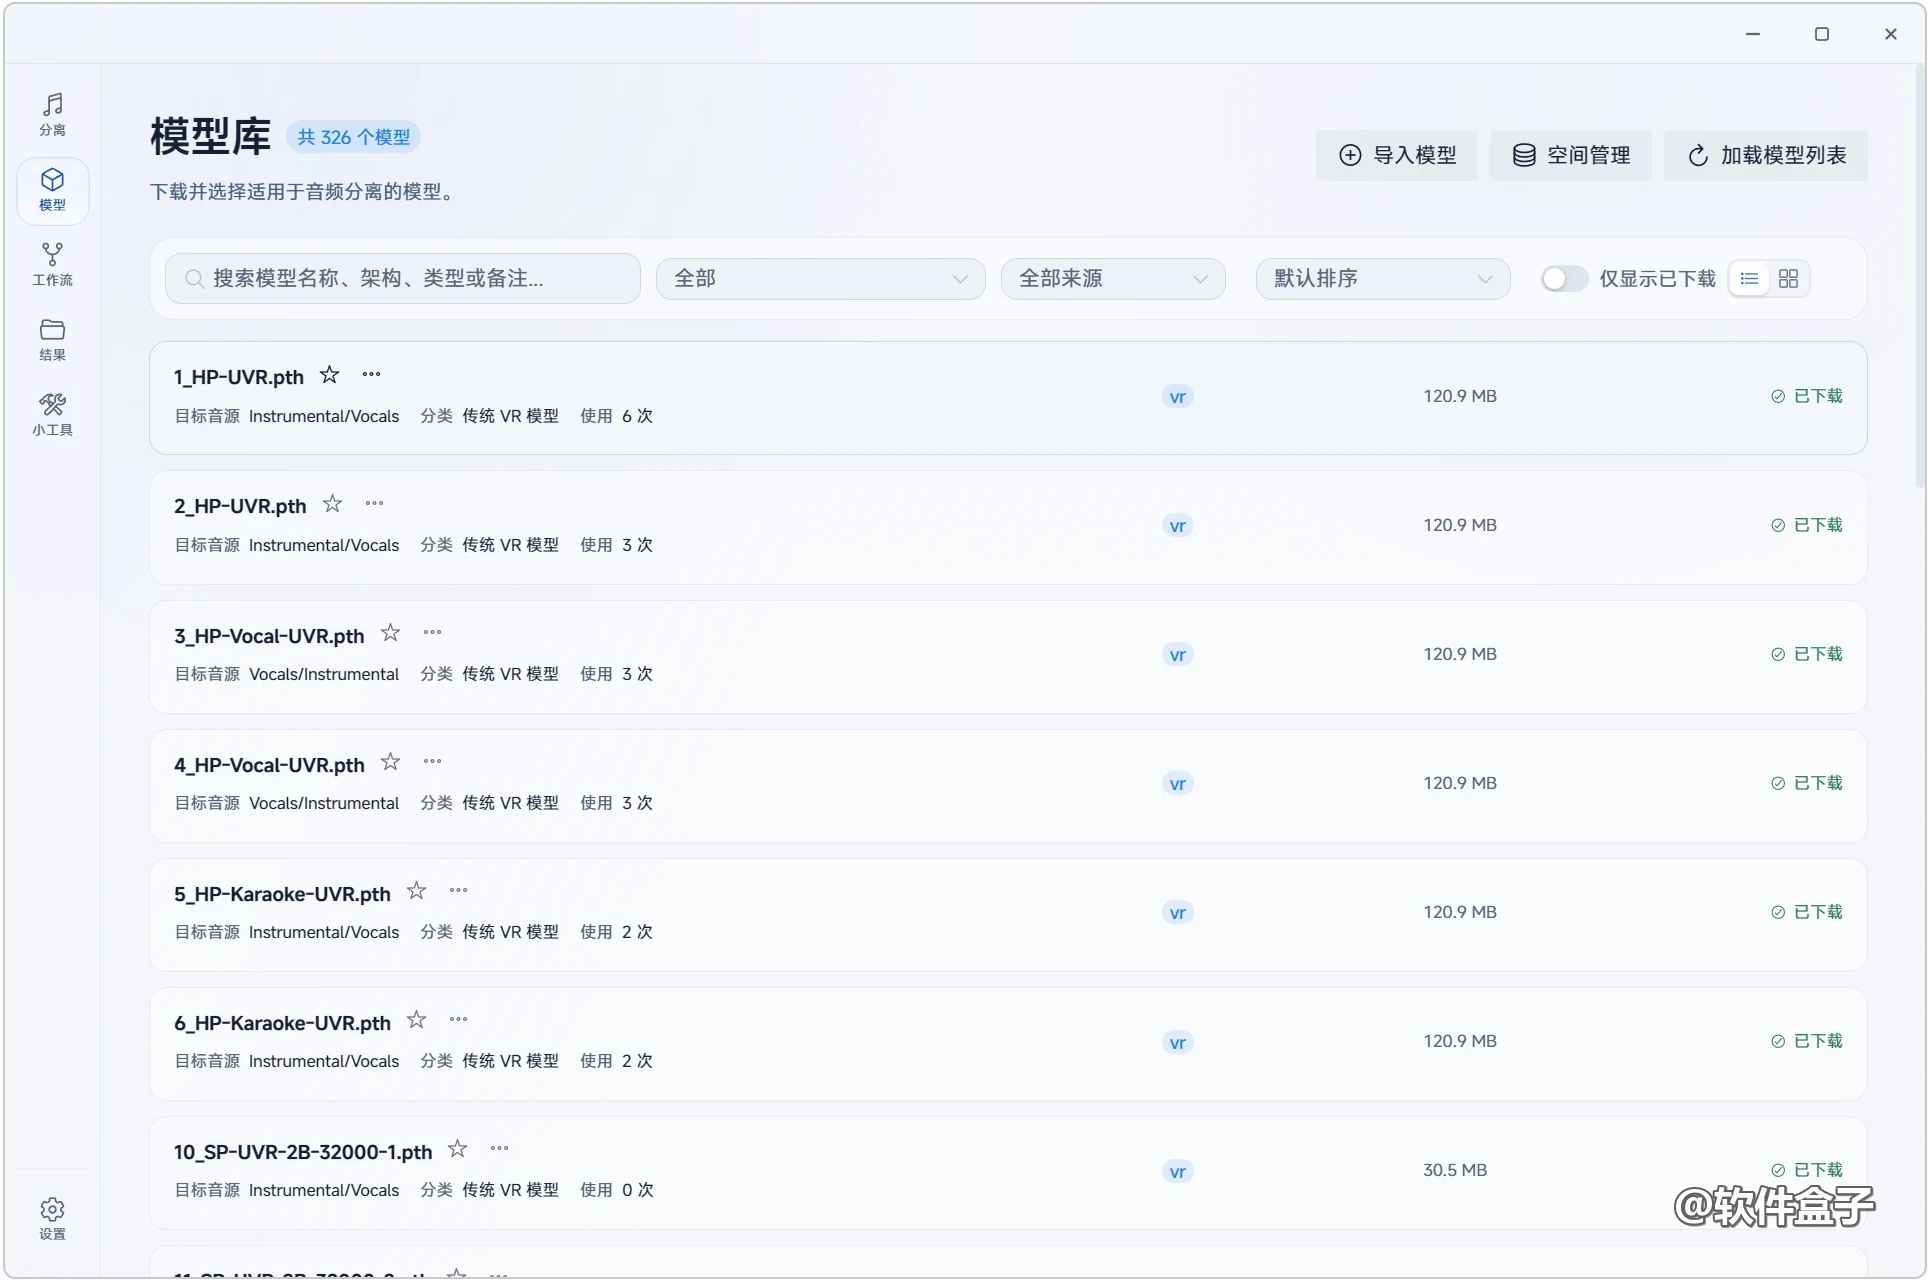
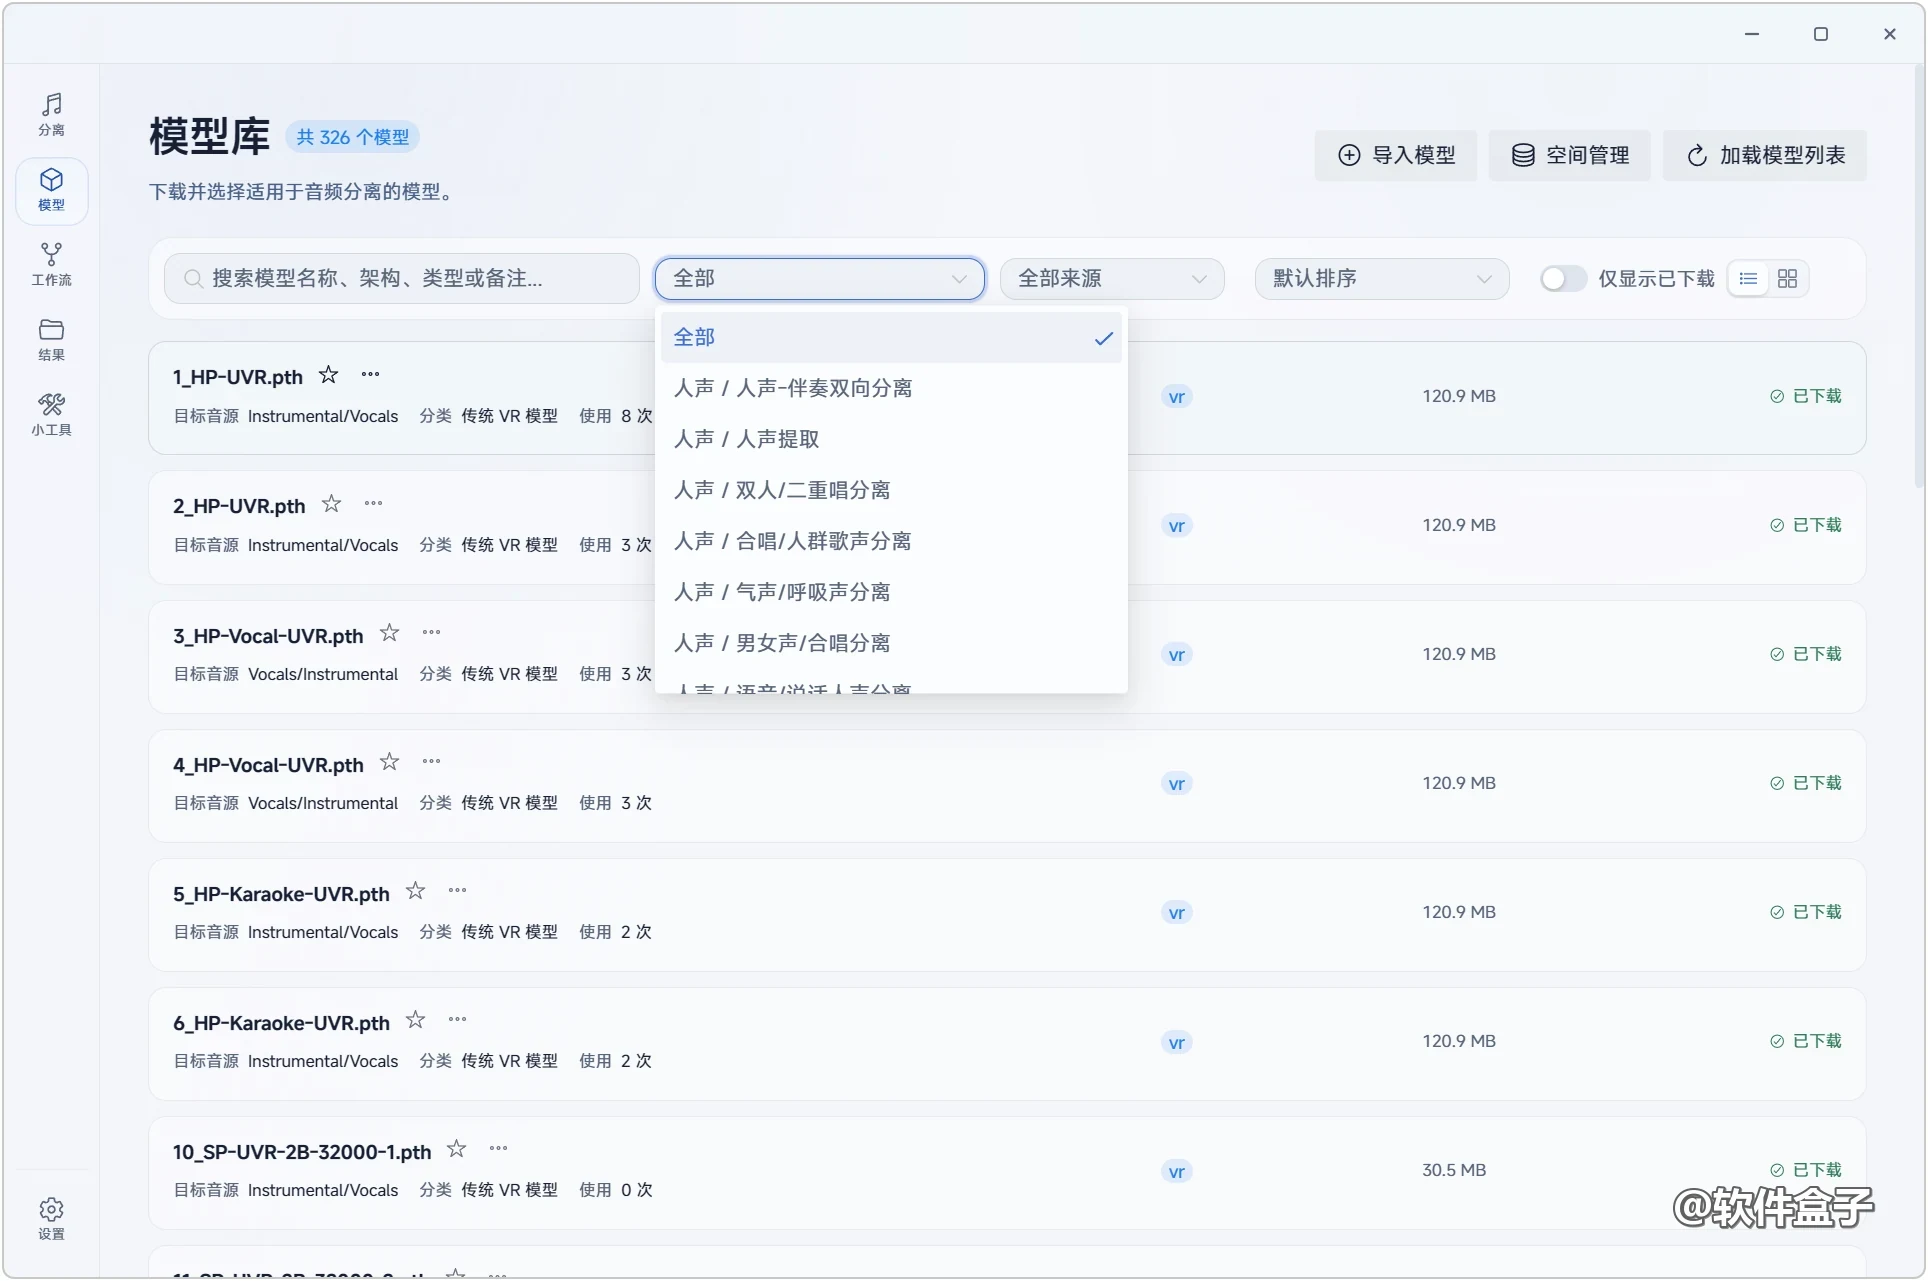
另外自带模型库,300多个模型,按自己需要挑合适的结构。
音源分离之外,格式转换:
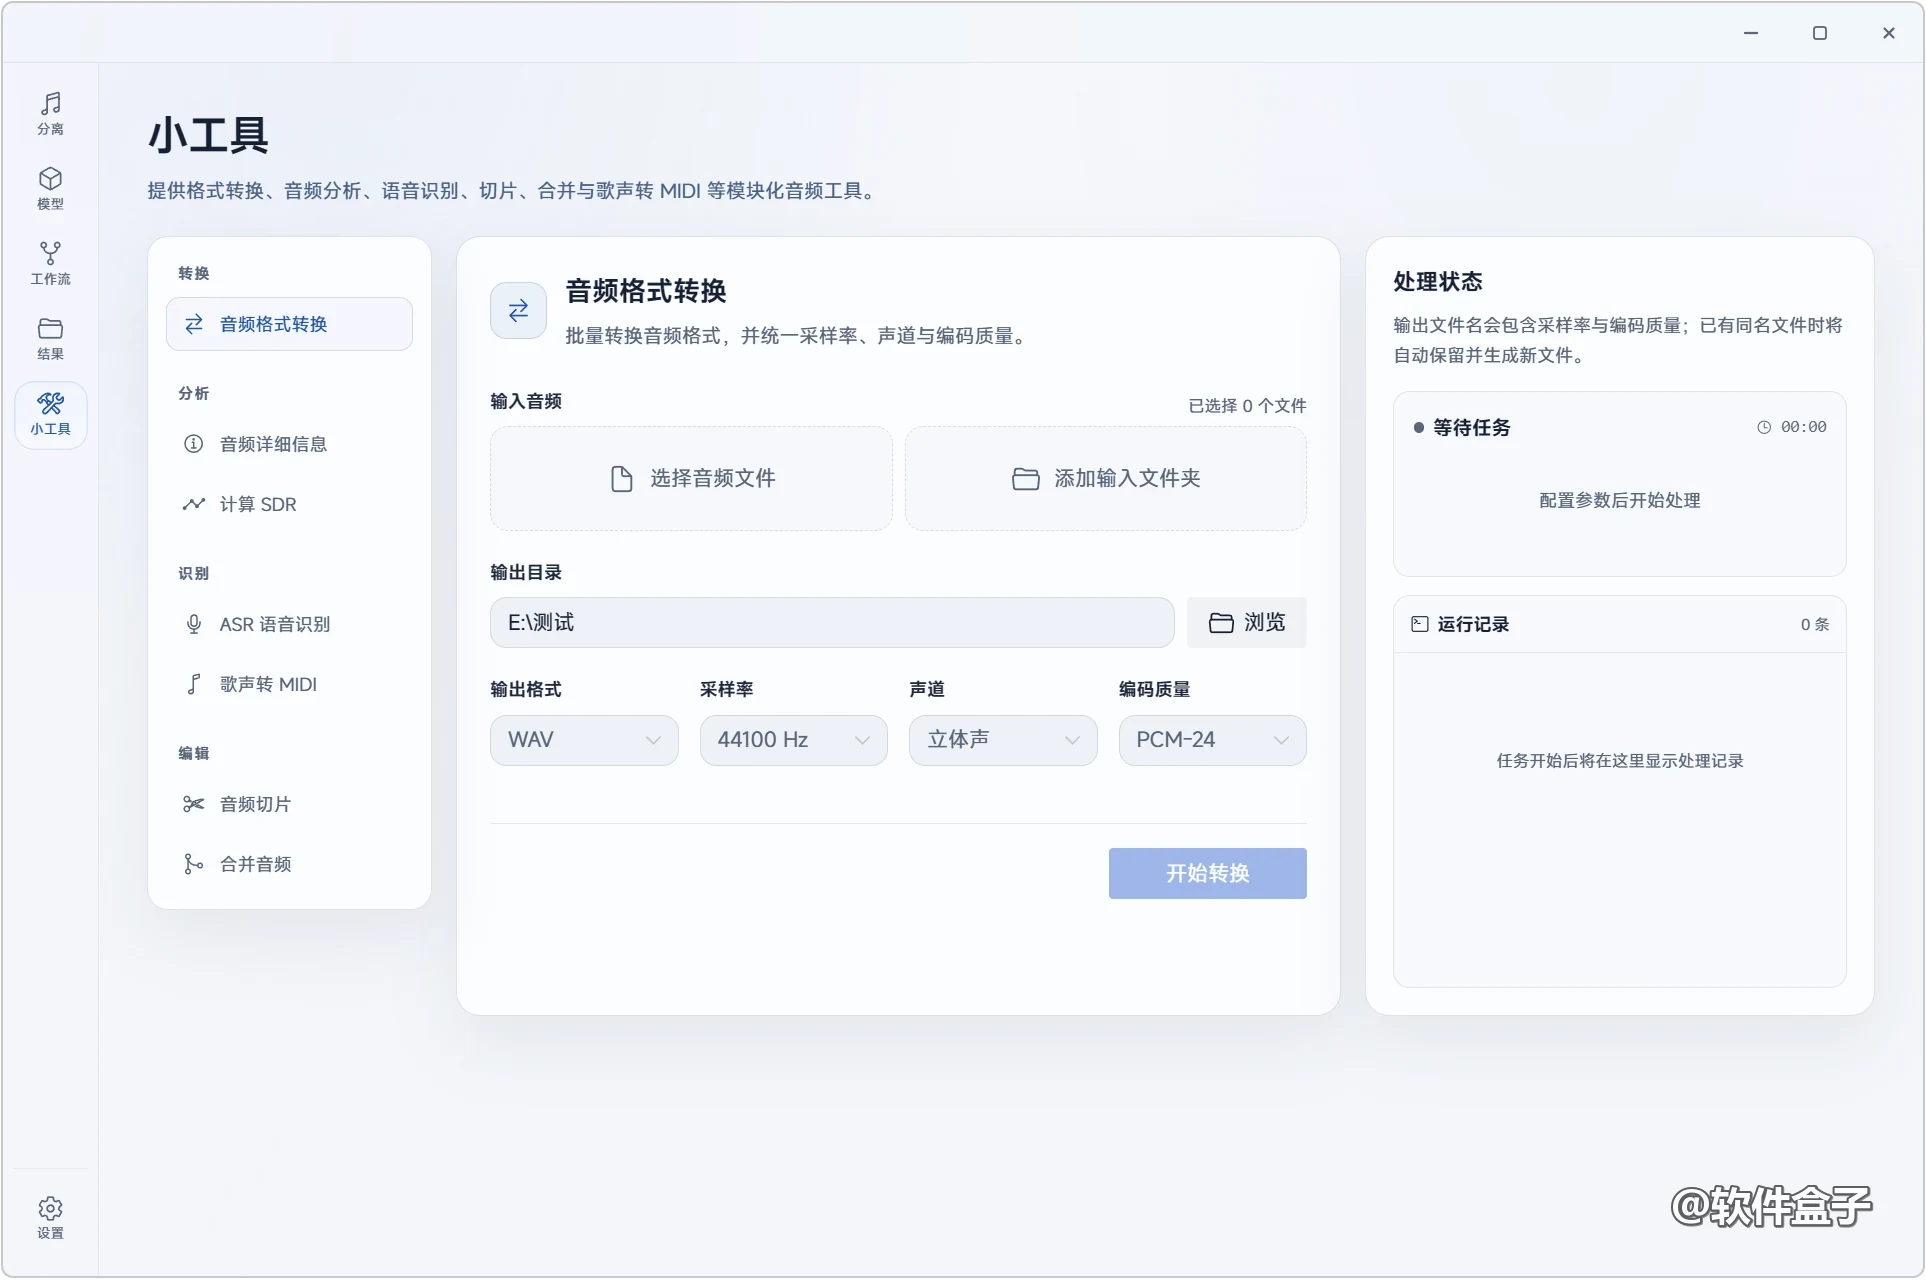
音频分析、语音识别:
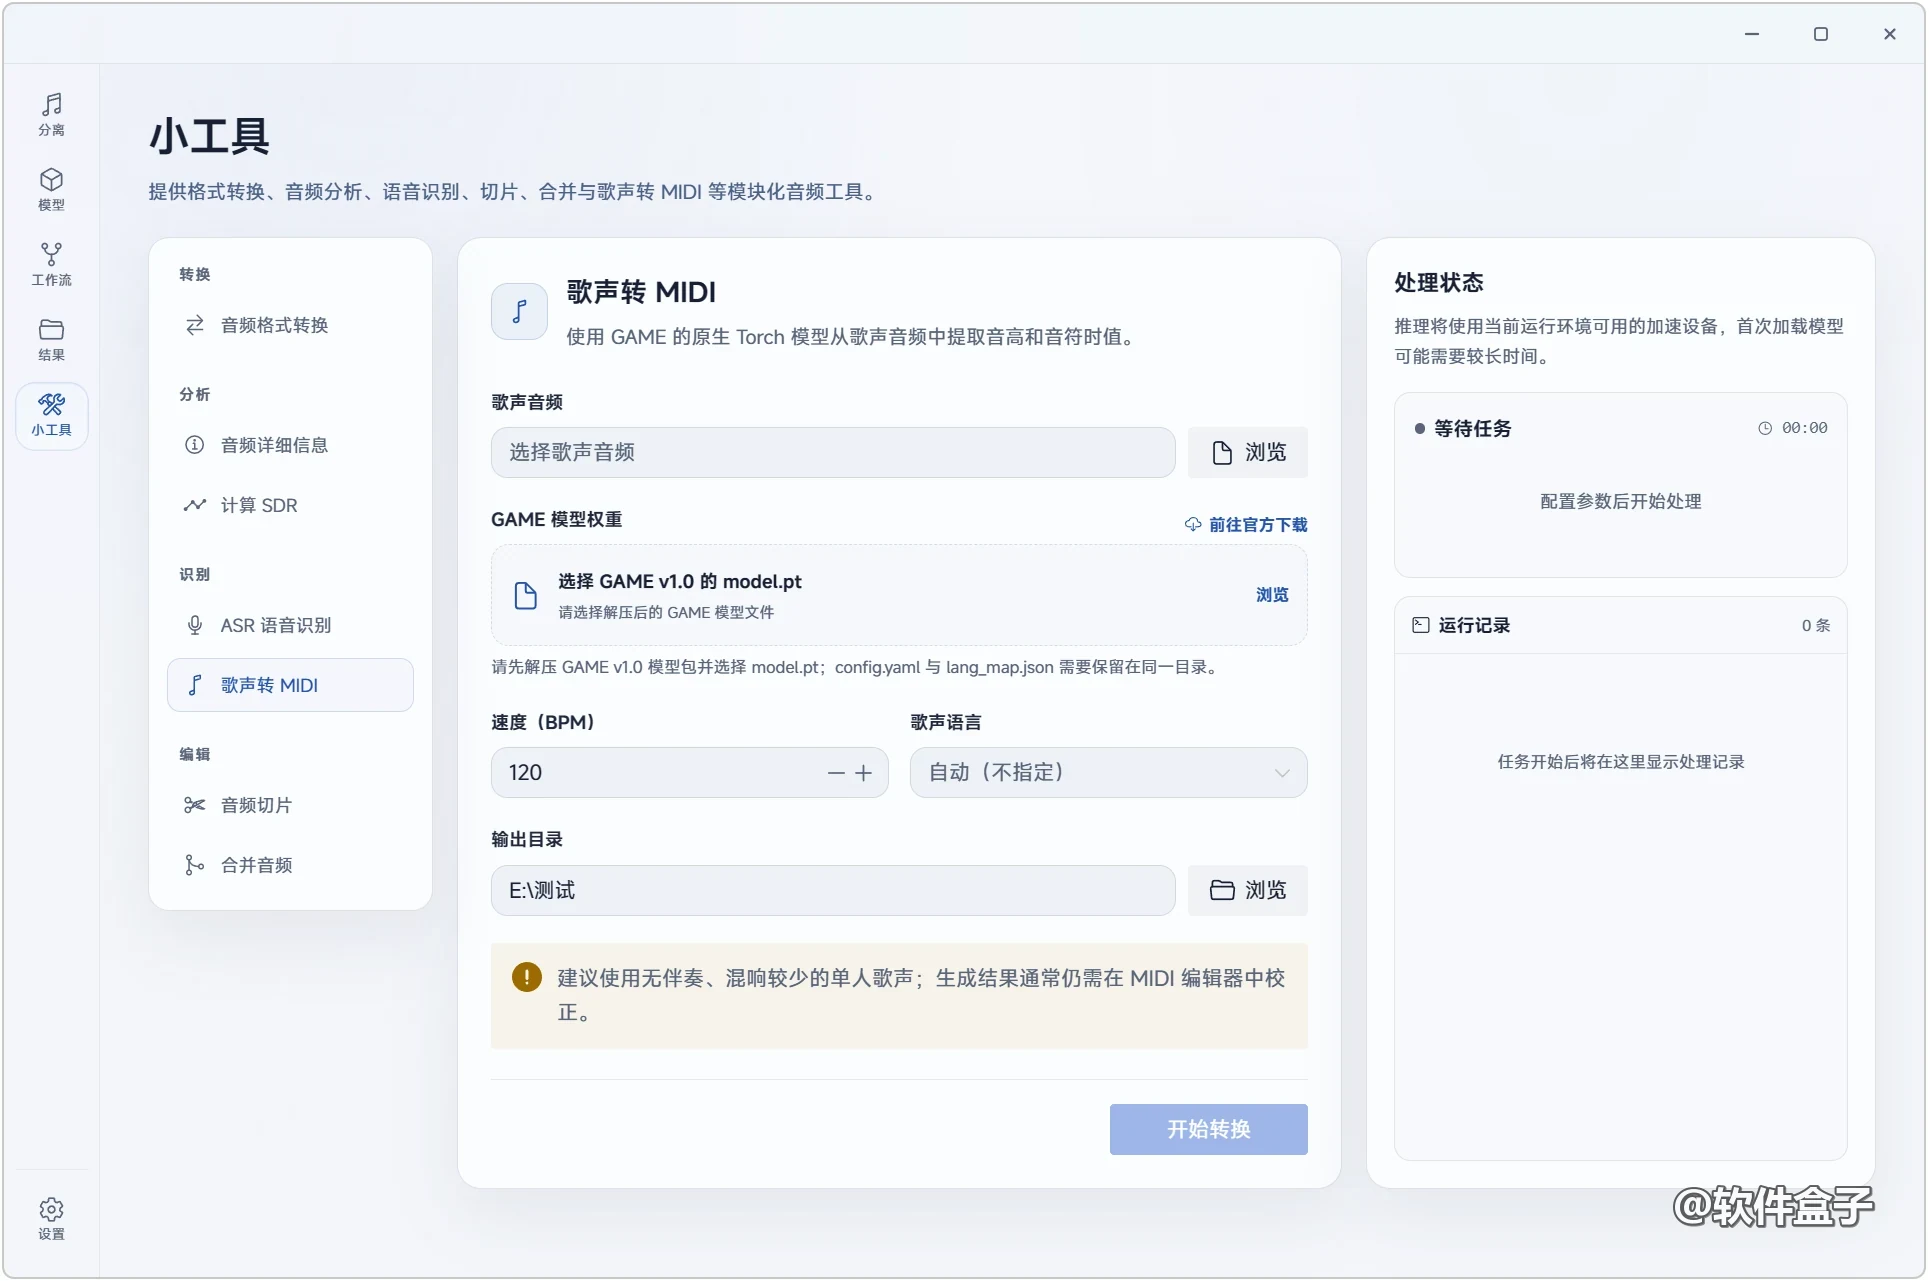
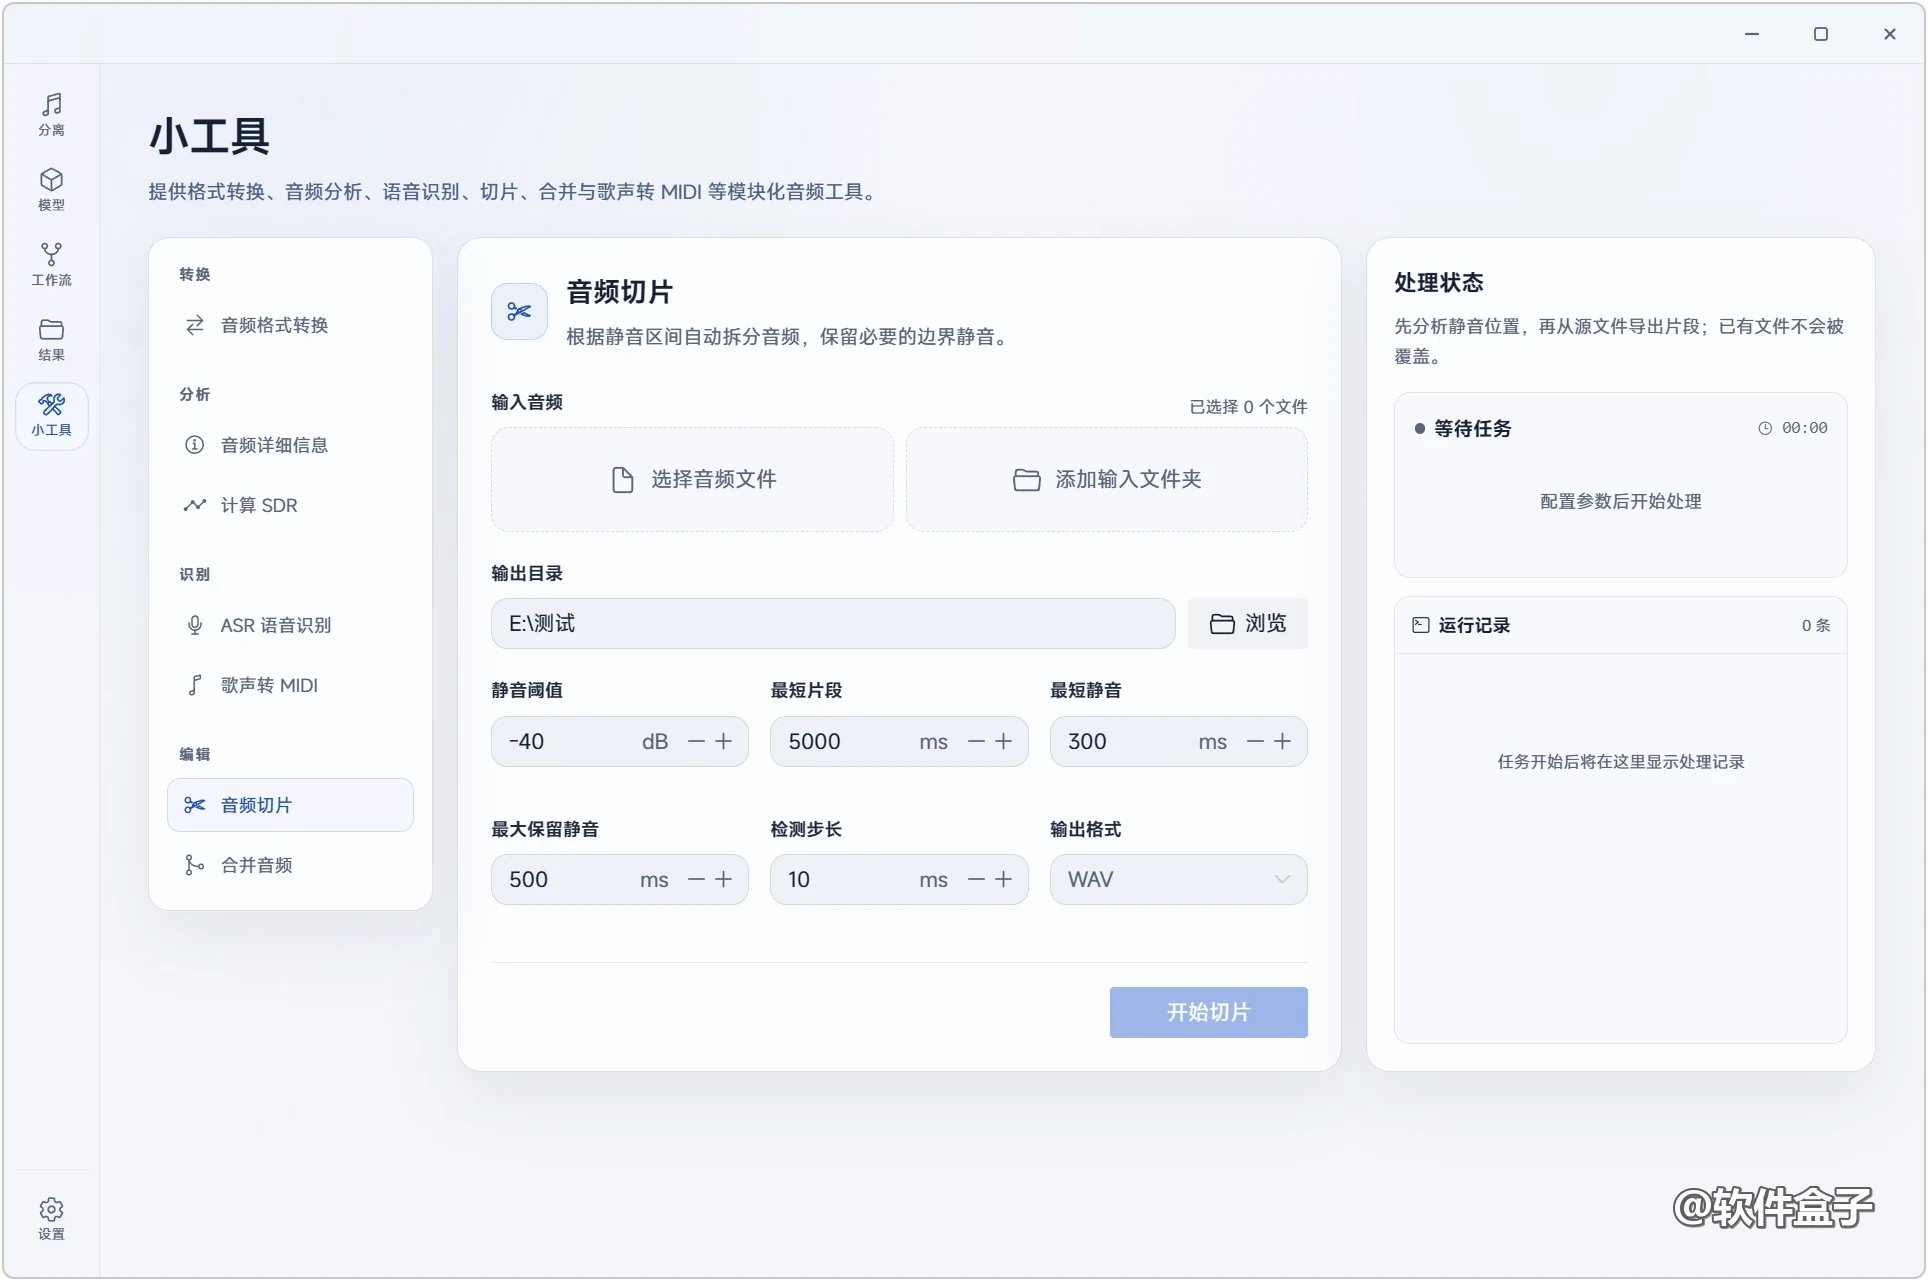
切片、合并音轨这些常用功能,也都配齐了。
说实话,这几年本地音频工具的进步,是真快。你们平时拆音轨,都用啥招?评论区聊聊。
用之前要知道
- 还支持工作流模式:
- 按自己需要挑合适的结构
- 下载与安装请核对版本号,安装前建议先备份重要数据。
本站只做整理与实测记录,资源来自网络公开分享,版权归原作者所有。